leecode Hot100 学习记录
前缀和
不单调数组求任意子数组和
前缀和概念和数列前n项和的概念很像,但是不包含最后一项(左闭右开),模版来自303. 区域和检索 - 数组不可变 - 力扣(LeetCode)
主要特点是,通过定义一个数组前缀和,就可以只需要O(1)复杂度求出任意一个子数组的和结果。
//leecode303.区域和检索:计算前缀和的模版实现

public class NumArray {
    private final int [] s;
    public NumArray(int [] nums) {
        s = new int [nums.length+1];
        for (int i = 0; i <nums.length; i++) {
            s[i+1] =s[i] + nums[i];//默认定义了s【0】为0
        }
    }
    public int sumRange(int left, int right) {
        return s[right+1]-s[left];
    }
}应用这个定义可以做560. 和为 K 的子数组 - 力扣(LeetCode)
Q:为什么要用前缀和?
A:因为这个待求的数组是不单调的。使用前缀和定义的数据结构,两个值相减可以求出来任意一个子数组的和。滑动窗口需要满足单调性,当右端点元素进入窗口时,窗口元素和是不能减少的。本题 nums 包含负数,当负数进入窗口时,窗口左端点该往哪个方向移动?无法确定。如果没有负数的话,则可以用滑动窗口。
于是转换成 s[j]-s[i] = k 这样的问题。可以看成是两数之和的变种。
s[j] = k + s[i] => s[right]-k = s[left] , 然后使用哈希表,快速定位是否存在,存在了就说明加1,最后合并所有的值。这里注意必须要用sj-k而不是si+k。这是因为,我们需要进行遍历来填充哈希表,在遍历的过程中去寻找符合条件的i与j。由于j大于i,也就是说,我们只有先知道了j才能知道i。遍历过程是只能先知道遍历到的元素的值,是只能给遍历过的元素key赋值value的。因此,我们只能求得si。因为si表示就是在当前元素sj之前的元素。
两数之和变体:选择更大的那个值与target计算,求之前遍历过的是否存在小的那个值。
public int subarraySum(int[] nums, int k) {
        int [] s = new int[nums.length+1];
        for (int i=0;i<nums.length;i++){
            s[i+1] =  s[i]+nums[i];
        }
        int ans = 0;
        Map<Integer, Integer> map = new HashMap<>();
        for (int i = 0; i <s.length ; i++) {
            ans += map.getOrDefault(s[i]-k,0);//查询已有的哈希表
            map.put(s[i],map.getOrDefault(s[i],0)+1);//创建前缀和的值的哈希表元素
        }
        return ans;
}同样的问题可以解决:53. 最大子数组和 - 力扣(LeetCode)
实际上这个需要计算最大数组和,多考虑一步就是如何得到最大数组和,s[i] - min(s[k])。我们依旧遍历一次前缀数组,但是我们记录前缀数组最小的部分在哪里,然后用当前的和减去之前的最小的和,可以求得当前最大的值。遍历一轮不停更新最小的和与最大的值,就可以得到最终的结果了。注意:min需要从s[0]开始,而这道题目必须要先比较最大值,再更新最小和,否则会将只有一个元素的数组误求成0。
public int maxSubArray(int[] nums) {
           int []sum =  new int[nums.length+1];
           for (int i = 0; i < nums.length; i++) {
                    sum[i+1] = sum[i] + nums[i];
           }//求出前缀和数组
           int min = 0;
           int maxVal = Integer.MIN_VALUE;
           for (int i = 1; i < sum.length; i++) {
               if (sum[i]-min > maxVal){
                   maxVal = sum[i]-min;
               }
               if (sum[i] < min){
                   min = sum[i];
               }
           }
           return maxVal;
    }
平衡码问题
3.22蚂蚁笔试题目02:平衡码问题,也是使用前缀和变体解决的思路。
解题思路:
数学规律:
观察0-9发现数学规律:平衡码和非平衡码是交替的。
如果是奇数,每个尾数为0-9的区间,都是平衡和不平衡对半分,最后一个区间也有偶数个元素,也是对半分,因此总共是(x+1)/2平衡的个数(包含0)。如果是偶数,就单独判断当前的数是否是平衡码,前面的奇数个按照奇数算。
DP:
核心思想:按位递归填数 + 记忆化缓存,将 “遍历所有数字” 的指数级时间,降为 “遍历唯一状态” 的线性级时间,避免重复计算;
状态设计(唯一场景):固定模板 = 位序(pos)+ 核心统计状态(如本题的数位和奇偶性 parity)+ 限制状态(limit),三个维度唯一决定后续填数规则和统计结果;
- pos:当前填到第几位,保证按位遍历不重不漏;
- parity:当前数位和的奇偶性,对应本题的统计目标;
- limit:当前位是否受原数限制(1 = 受限,0 = 不受限),保证填出的数≤原数 x;
缓存价值:缓存存储 “唯一场景的统计结果”,同一 x 的不同填数分支走到同一场景时,直接复用结果,无需重复遍历;
关键操作:
- 递归终止:所有位填完后,根据核心状态(parity)判断是否为目标数;
- 状态传递:遍历当前位所有可能数字,计算新的 limit(是否继续受限)和核心状态,递归累加结果;
- 缓存命中:已计算的状态直接返回,未计算则计算后存入缓存。
//数学规律
-----------------------------------------------------------------------------------------
//    判断一个数是不是平衡码
    private int isBanlanceCode(long num){
        String str = String.valueOf(num);
        int sum = 0;
        for (char c:str.toCharArray()){
            sum += c-'0';
        }
        return  sum%2==0?1:0;
    }
    //计算0-x之间的平衡码个数,数学规律:0-9平衡和不平衡是和奇偶一样交替的。
    //如果是奇数,每个尾数为0-9的区间,都是平衡和不平衡对半分,最后一个区间也有偶数个元素,也是对半分,因此总共是(x+1)/2平衡的个数(包含0)
    private long countBalanced(long num){
        if(num==0){
            return 1;
        }
        if (num%2!=0){
            //如果是奇数就好办了
            return (num+1)/2;
        }else{
            //如果是偶数,前面就按奇数处理,并加上最后x的结果
            return num/2 + isBanlanceCode(num);
        }
    }

//数位DP
-----------------------------------------------------------------------------------------
    //定义记忆缓存:描述当前位的情况
    long[][][] dp;
    //使用数位DP去求0-x有多少平衡码,拆分位数,一位一位地去填,统计数位之和状态
    private long countBalanced2(long num){
        if(num==0){
            return 1;
        }
        String str = String.valueOf(num);
        int len = str.length();
        int[]digit = new int[len];
        for (int i=0;i<len;i++){
            digit[i] = str.charAt(i)-'0';
        }
        dp = new long[len][2][2];
        for (int i=0;i<len;i++){
            for (int j=0;j<2;j++){
                for (int k=0;k<2;k++){
                    dp[i][j][k] = -1;//初始化缓存
                }
            }
        }
       return dfsBalanceCode(0,0,1,digit);
    }

    //02 dfs写数位DP的做法

    /**
     * @param pos    当前要填写的位置
     * @param parity 当前填写之前数位之和是否能%2(0就是偶数)
     * @param limit  当前填写能否无限制填(0-9)
     * @param digit  待检测的数字X
     * @return 所有位置填完之后统计出来的平衡码的个数
     */
    private long dfsBalanceCode(int pos,int parity, int limit,int[]digit){
        if(pos==dp.length){
            return parity==0?1:0;
        }
        if (dp[pos][parity][limit]!=-1){
            return dp[pos][parity][limit];
        }
        long res = 0;
        int maxDigit = limit == 1 ? digit[pos] : 9; // 当前位能填的最大数字
        for (int i=0;i<=maxDigit;i++){
            // 计算新的限制:上一轮受限 + 当前填了最大值 → 下一轮受限
            int newLimit = (limit == 1 && i == maxDigit) ? 1 : 0;
            // 计算新的奇偶性:当前奇偶 + 当前数字,取模2
            int newParity = (parity + i) % 2;
            res += dfsBalanceCode(pos + 1, newParity, newLimit, digit);
        }
        dp[pos][parity][limit] = res;
        return res;
    }
-----------------------------------------------------------------------------------------
    //3.22蚂蚁笔试
    //01平衡码问题,寻找区间[l,r]之间的"数位之和为偶数"的元素个数
    public void banlanceCode(String []args){
        //需要写输入
        Scanner sc = new Scanner(System.in);
        //一共有几组数据
        int total  =  sc.nextInt();
        for (int i=0;i<total;i++){
            //每组数据的输入
            long left  =  sc.nextLong();
            long right  =  sc.nextLong();
            //解决问题:统计区间之间的平衡码个数
//            方法1:使用数学规律做法
            long res = countBalanced(right) - countBalanced(left-1);

//            方法2:数位DP
            long resDP = countBalanced2(right) - countBalanced2(left-1);
            System.out.println(resDP);

        }
        sc.close();
}| 方法类型 | 核心时间复杂度(单个数 x) | 扩展到 T 组测试用例 | 关键说明 |
|---|---|---|---|
| 数学规律法 | O (log₁₀x)(或 O (k),k 是 x 的位数) | O(T×log₁₀x) | 核心操作是遍历 x 的数位(如计算数位和),位数 k 与 x 的关系为 k=log₁₀x,常数级效率(如 18 位仅需 18 次操作) |
| 数位 DP 法 | O (log₁₀x)(或 O (k)) | O(T×log₁₀x) | 核心是计算 k×2×2=4k 个唯一状态(k 为位数),每个状态遍历最多 10 次,仍为位数级线性复杂度 |
Scanner使用
1.基本类型读取方法(按类型选)
这类方法会自动跳过输入中的「空白符」(空格、Tab、换行),直接读取对应类型的数值,读取失败会抛 InputMismatchException
一般用的最多的是nextInt()和nextLong(),看数据范围大于2^31就用long
2.字符串读取方法(按格式选)
| 方法 | 核心规则 | 适用场景 |
|---|---|---|
next() | 1. 跳过开头空白符;2. 遇到空格 / 换行停止;3. 只返回中间非空白字符串 | 读取不含空格的单个字符串(如用户名、密码) |
nextLine() | 1. 读取从当前光标到换行符的所有内容;2. 包含空格;3. 读取后跳过换行符 | 读取含空格的整行文本(如地址、一句话) |
混合使用基本类型 + nextLine () 的问题
这是最常见的错误!比如先调用 nextInt(),再调用 nextLine(),会发现 nextLine() 直接跳过输入,原因是:
nextInt()只读取数值,不会读取输入后的换行符(\n);后续的
nextLine()会直接读取这个残留的换行符,返回空字符串。解决方法:
在
nextInt()/nextLong()等之后,加一个sc.nextLine()「吃掉」残留的换行符:java
滑动窗口求最大值
使用方法:单调队列
“及时去除无用数据,保证双端队列有序”
模拟滑动窗口的过程,发现:如果新加入的比前面的大,那么很可能是窗口最大值。而前面已经加入的肯定不可能是最大值(要比更大的先脱离窗口);而新加入的比前面的小的时候,新加入的元素仍然有可能变成最大值(当后来的逗比新加入的小)
所以最后我们希望记录下最可能成为最大值的元素,而去掉不可能成为最大值的元素,构成了一个单调的变动的集合。最终我们需要的数据结构是左出右进/右出的结构,因此使用的是双端队列。
由于队列维护的结构都是单调的,因此这个方法也叫做单调队列。
说实在的,理解这道题突然有点破防:后来进滑动窗口的一定比窗口里面的更加**’‘年轻‘’**,新来的寿命比你长,价值还比你大,凭什么还留着你个老登。你不可能成为最大的那个了。如果新来的没你有价值,其实你还是有可能成为最大的地位的。退位也是以后的事。
具体代码如下:每个元素只会进一次队列出一次队列,虽然看着是两个循环,但是时间复杂度是O(n),空间复杂度是O(k)
class Solution {
    public int[] maxSlidingWindow(int[] nums, int k) {
        int[] ans = new int[nums.length-k+1];
        Deque<Integer> q = new ArrayDeque<>();
        for (int i = 0; i < nums.length; i++) {
//           进
            while (!q.isEmpty() && nums[q.getLast()] < nums[i] ) {
                //后来者更大,需要删除已有的最新的,保证只留下最可能成为最大值的,可能要去掉多个所以用的是while而不是if
                q.removeLast();
            }
            q.addLast(i);
//            出,能出or该出就出
            int left = i-k+1;
            if (left >q.getFirst() ) {
                q.removeFirst();
            }
//            记录元素
            if (left>=0){
                ans[left]=nums[q.getFirst()];
            }
        }
        return ans;
    }
}
其他单调队列题目:
- 绝对差不超过限制的最长连续子数组 https://leetcode.cn/problems/longest-continuous-subarray-with-absolute-diff-less-than-or-equal-to-limit/
- 预算内的最多机器人数目 https://leetcode.cn/problems/maximum-number-of-robots-within-budget/
- 和至少为 K 的最短子数组 https://leetcode.cn/problems/shortest-subarray-with-sum-at-least-k/
- 满足不等式的最大值 https://leetcode.cn/problems/max-value-of-equation/
- 跳跃游戏 VI https://leetcode.cn/problems/jump-game-vi/
- 购买水果需要的最少金币数 https://leetcode.cn/problems/minimum-number-of-coins-for-fruits/
覆盖子串类问题
使用方法:数组记录每个字母出现次数,然后比较。
今天自己写出来的第一个hard题目:smile:(虽然判断函数的逻辑有问题抄的灵神的,但是主要逻辑都是自己一气呵成的!大大的进步!)
思路:这类题目给定一个长的串s,给定一个短串t。核心在于如何判断是否s的子串包含t。这个题目要求的是只要覆盖了就行。如abvc覆盖了abc。核心在于写判断什么时候覆盖的逻辑。需要自定义一个函数进行判断。主要逻辑就是滑动窗口来收集所有的覆盖t的子串,然后记录到哈希表里面最后拿出最小的那个就行。
时间复杂度:O(52 * n) = O(n),其中n是字符串s的长度
- isCovered方法:每次调用需要遍历52个字符(26个大写字母 + 26个小写字母),时间复杂度O(52)
- minWindow方法:
- 初始化:O(|t|),统计t中字符频率
- 双指针遍历:O(n),n是s的长度
- 每次移动指针时可能调用isCovered:最坏情况下O(52*n)
具体个人代码如下:
class Solution {
   private boolean isCovered(int[] cntS, int[] cntT) {
        for (int i = 'A'; i <= 'Z'; i++) {
            if (cntS[i] < cntT[i]) {
                return false;//反着来快,有一个反例就不行
            }
        }
        for (int i = 'a'; i <= 'z'; i++) {
            if (cntS[i] < cntT[i]) {
                return false;
            }
        }
        return true;
    }

      public String minWindow(String s, String t) {
        int [] countT = new int[128];
        int [] countS = new int[128];
        Map<Integer,String> map = new HashMap<>();
        int min = Integer.MAX_VALUE;
        for (int i=0;i<t.length();i++){
            countT[t.charAt(i)]++;
        }//统计出来每个字母的频率
        int left = 0;
        int right = 0;
        while (right < s.length()){
            countS[s.charAt(right)]++;
            right++;
            if (isCovered(countS, countT)){
                while(left<right && isCovered(countS, countT)){
                    countS[s.charAt(left)]--;
                    left++;//这个left一定会加,好处就是实际上最后的left一定是新的滑动窗口起点,继续找子串,而不是停留在原地陷入死循环。
                }
                map.put(right-left+1,s.substring(left-1,right)) ;//这里得注意,left一定要减一,right前面也是加了之后的所以直接用就行。substring是左闭右开,这里不需要用right+1;
                min = Math.min(min,right-left+1);
            }
        }
        if (map.containsKey(min)){
            return map.get(min);
        }
    return "";
    }
}
数组
区间合并问题
使用方法:排序
合并区间的关键在于,必须先都按照左端点进行排序,这样就可以仅关注右边端点。一旦出现下一个左端点是大于当前的右端的值,那么当前的区间一定就是固定的结果区间了。因为排序之后不存在后面的其他区间左端点比下一个左端点小。
两个关键代码:写排序的比较器;写比较过程的分支结构
关于比较器:
Comparator 是 Java 中的一个函数式接口,位于 java.util 包下。它定义了一个用于比较两个对象的方法 compare,该方法接受两个参数,并返回一个整数值。返回值的含义如下:
- 如果返回值小于 0,表示第一个参数小于第二个参数。
- 如果返回值等于 0,表示两个参数相等。
- 如果返回值大于 0,表示第一个参数大于第二个参数。
也就是说,如果写(a,b)->return a - b; 就肯定是正序了,因为如果a大,那么返回的就是正数,而a实际就会排在后面了。反之,如果写成return b-a,那么就是倒序,因为b大,返回正数,让a排在了b的前面。也就是说,返回值的符号实际上表示了第一个参数和第二个参数的关系,谁小谁在前,谁大谁靠后,然后才看出来是不是正序/倒序。
具体代码如下:
 public int[][] merge(int[][] intervals) {
        List<int []> ans = new ArrayList<>();
        Arrays.sort(intervals,(a,b)->a[0]-b[0]);//正序排序左端点
        for (int i = 0; i < intervals.length; i++) {
            if (!ans.isEmpty() && ans.getLast()[1]>=intervals[i][0]){
                ans.getLast()[1]=Math.max(ans.getLast()[1],intervals[i][1]);
            }else  {
                ans.addLast(intervals[i]);
            }
        }
        return ans.toArray(new int[ans.size()][]);
    }
轮转数组
关键在于两个注意点:
一是要将k取模,大于数组长度的k相当于先转一圈(没变)再转几个,需要防止数组越界;
二是了解java特性,java没有指针,传递的是数组的引用。在Java中,数组是对象,所以当数组作为参数传递时,传递的是引用(内存地址),而不是数组本身的副本。
class Solution {
    public void ratateUtil(int [] nums,int start,int end){
        int l = start;
        int r = end;
        while( l < r){
            int temp = nums[l];
            nums[l] = nums[r];
            nums[r] = temp;
            l++;
            r--;
        }
    }

    public void rotate(int[] nums, int k) {
            k = k % nums.length;
            ratateUtil(nums,0,nums.length-1);
            ratateUtil(nums,0,k-1);
            ratateUtil(nums,k,nums.length-1);


    }
}
求除自身外数组乘积
题目238. 除自身以外数组的乘积 - 力扣(LeetCode)
关键点:这道题目不能用除法,要模仿前缀和的方法,实际上可以用前缀乘积和后缀乘积来做。直接用前缀*后缀就可以了。
//普通方法
public int[] productExceptSelf(int[] nums) {
//        先计算前缀后缀
        int [] pre =  new int[nums.length+1];
        pre[0] = 1;
        int [] suf =  new int[nums.length+1];
        suf[nums.length-1] =1;//注意前缀和后缀的初始化都是基于源数组的起始和末尾的,乘积所以用1初始化
        for (int i = 1; i <=nums.length; i++){
            pre[i] = pre[i-1]*nums[i-1];
        }
        for (int i = nums.length-2; i >=0; i--){
            suf[i] = suf[i+1]*nums[i+1];
        }

        int []res =  new int[nums.length];
        for(int i =0;i<nums.length;i++){
            res[i] = pre[i]*suf[i];
        }
        return res;
    }


//优化空间复杂度的方法
public int[] productExceptSelf(int[] nums) {
        int n = nums.length;
        int[] suf = new int[n];
        suf[n - 1] = 1;
        for (int i = n - 2; i >= 0; i--) {
            suf[i] = suf[i + 1] * nums[i + 1];
        }

        int pre = 1;
        for (int i = 0; i < n; i++) {
            // 此时 pre 为 nums[0] 到 nums[i-1] 的乘积,直接乘到 suf[i] 中
            suf[i] *= pre;
            pre *= nums[i];
        }

        return suf;
    }
缺失的第一个正数
题目:41. 缺失的第一个正数 - 力扣(LeetCode)
注意:这道题目需要时间复杂度为O(n),空间复杂度为O(1)。所以核心在于交换,我们的排查方式就是让每个数归位到正确的位置上,然后从头开始找第一个不在位置的正数;如果找不到就是n+1。
- 缺失的第一个正数表明一定是范围在1-n,不可能更大,作为交换判断的条件。这种场景下的交换排序的时间复杂度依旧是O(n)
- 一直换到当前的位置变成正确的值。
 public int firstMissingPositive(int[] nums) {
        for (int i = 0; i < nums.length; i++) {
            //给数组的每个数找他们应该在的位置,发现不对就交换。让原本的数组从1开始。所以这里用的是=nums[nums[i]-1]
            while(nums[i]>=1 && nums[i]<=nums.length && nums[i]!=nums[nums[i]-1]){
                int temp = nums[nums[i]-1];
                nums[nums[i]-1] = nums[i];
                nums[i] = temp;
            }
        }
     //因此这里的判断是i+1,因为当前格子实际数组是1-n的顺序,是比索引大一。
        for (int i = 0; i < nums.length; i++) {
            if (nums[i] != i+1) {
                return i+1;
            }
        }
        return nums.length+1;
    }
矩阵
螺旋矩阵
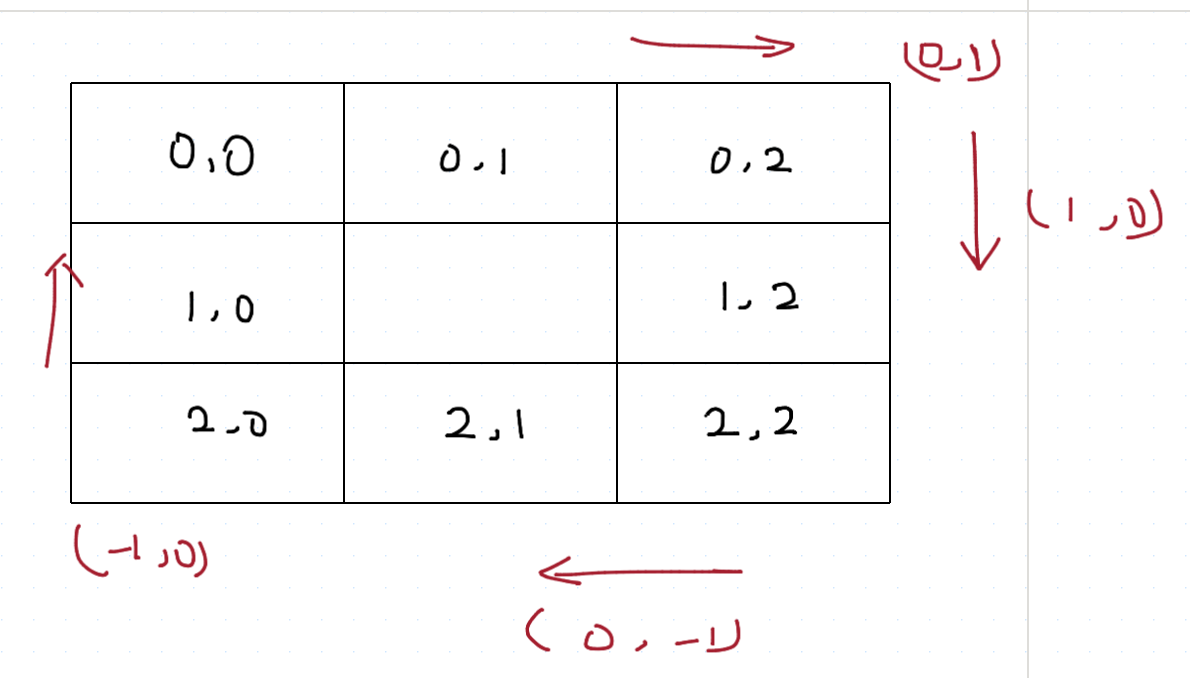
重点在于使用一个二维数组当做下一步的方向上的增减,并提前预判下一步是否超界或者遍历过,根据条件转向。
public List<Integer> spiralOrder(int[][] matrix) {
        int m =  matrix.length;
        int n = matrix[0].length;
        List<Integer> ans = new ArrayList<>();
        int[][] copy = new int[m][n];//防止更改原本的数组
        for (int i = 0; i < matrix.length; i++) {
            copy[i] = Arrays.copyOf(matrix[i], matrix[i].length);
        }
        int [][]DIRECTION = new int [][]{{0,1},{1,0},{0,-1},{-1,0}};
        int i=0,j=0;
        int di = 0;//表示现在是哪个方向
        for (int k = 0; k < n*m; k++) {
            ans.add(matrix[i][j]);
            copy[i][j] = Integer.MAX_VALUE;
            int x = i+DIRECTION[di][0];
            int y = j+DIRECTION[di][1];
            if (x<0 || x>=m || y<0 || y>=n || copy[x][y]==Integer.MAX_VALUE) {
                di = (di+1) % 4;//该转向了
            }
            i = i+DIRECTION[di][0];
            j = j+DIRECTION[di][1];
        }

        return ans;
    }
顺时针旋转矩阵
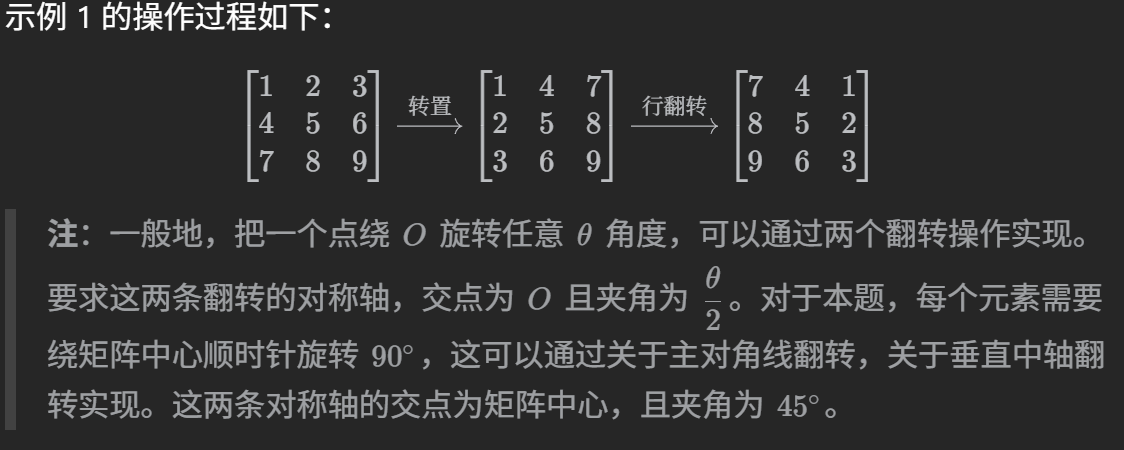
代码很简单,一次转置+一次横对称。但是原理需要理解:
顺时针旋转90°的具体实现
对于顺时针旋转90°:
- θ = 90°,所以两条对称轴夹角应为45°
- 具体操作:
- 先关于主对角线翻转(左上到右下的对角线)
- 再关于垂直中轴翻转(矩阵的垂直中线)
   public void rotate(int[][] matrix) {
        for (int i = 0; i < matrix.length; i++) {
            for (int j = 0; j < i; j++) {//转置只对对角线下的元素操作。
                int temp = matrix[i][j];
                matrix[i][j] = matrix[j][i];
                matrix[j][i] = temp;
            }
        }
        for (int i = 0; i < matrix.length; i++) {
            for (int j = 0; j < matrix[i].length/2; j++) {
                int temp  = matrix[i][j];
                matrix[i][j] = matrix[i][matrix[i].length-j-1];//对称交换
                matrix[i][matrix[i].length-j-1] = temp;
            }
        }
    }
二维有序矩阵查找
笨办法就是每行用个二分法。
记得用优化后的写法:int mid = left + (right-left)/2;
灵神的写法是,每次只看右上角的:大就删列,小就删行。
时间复杂度O(m+n)
public boolean searchMatrix(int[][] matrix, int target) {
       int i = 0;
       int j = matrix[0].length-1;
       while (i < matrix.length && j >= 0){
           if (matrix[i][j] == target){
               return true;
           }else if (matrix[i][j] > target){
               j--;
           }else {
               i++;
           }
       }
        return false;
    }
链表
相交链表
其实这个题我会,但是灵神的代码实在太牛逼了,记一下
这个代码是寻找两个链表的交点。
原理: 两个指针分别从两个链表头开始,同步前进。当一个指针到达链表末尾时,它跳到另一个链表的头继续前进。这样两个指针走过的总路程相同,如果有交点,它们最终会在交点处相遇。
class Solution {
    public ListNode getIntersectionNode(ListNode headA, ListNode headB) {
        ListNode p = headA;
        ListNode q = headB;
        while (p != q) {
            p = p != null ? p.next : headB;
            q = q != null ? q.next : headA;
        }
        return p;
    }
}
两数相加
主要是为了看下简便的写法:
- 更优雅的边界处理:循环条件
while (l1 != null || l2 != null || carry != 0)确保所有情况都被处理,包括最后可能的进位。 - 统一的节点创建:不再需要多个if-else分支来决定是否创建新节点,而是统一创建新节点并更新carry值。
class Solution {
    public ListNode addTwoNumbers(ListNode l1, ListNode l2) {
        ListNode dummy = new ListNode(0); // 虚拟头节点
        ListNode curr = dummy;
        int carry = 0;

        while (l1 != null || l2 != null || carry != 0) {//概括三种情况
            int x = (l1 != null) ? l1.val : 0;//第一条链表的值
            int y = (l2 != null) ? l2.val : 0;//第二条链表的值
            int sum = carry + x + y;//暂时的和

            carry = sum / 10;//是否进位
            curr.next = new ListNode(sum % 10);//结果
            curr = curr.next;//下一个

            if (l1 != null) l1 = l1.next;
            if (l2 != null) l2 = l2.next;
        }

        return dummy.next;
    }
}
删除链表节点
换句话说,如果遇到需要删除头节点的题目,添加哨兵节点可以简化代码逻辑,请记住这个技巧。
加了一个头结点之后,删除时候就不需要额外讨论删除头结点的问题,如果真要讨论就看fast的状态,根据fast的位置判断是否删除头。
public ListNode removeNthFromEnd(ListNode head, int n) {
        ListNode pHead = new ListNode(0);
        pHead.next = head;
        ListNode fast = pHead;
        ListNode slow = pHead;
        int count = 0;
        while(fast!=null&&count<n){
            fast = fast.next;
            count++;
        }
        while(fast!=null && fast.next!=null){
            fast = fast.next;
            slow = slow.next;
        }
        slow.next = slow.next.next;

        return pHead.next;
    }
反转链表II
//反转链表2-片段反转  需要哨兵+pre /cur/next三个指针保证当前指向前面的,最后连接原链表和反转后的尾巴和头部。返回哨兵下一个
    public ListNode reverseBetween(ListNode head, int left, int right) {
        ListNode dummy = new  ListNode(0) ;
        dummy.next = head;
        ListNode p = dummy;
        int count = 0;
        while (count < left-1) {
            p = p.next;
            count++;
        }//p在left前一个,从这里开始反转
        ListNode pre = null;
        ListNode cur = p.next;
        while (count < right) {//遍历最后一次结束cur是反转的下一个,pre时反转的最后一个
            ListNode next = cur.next;
            cur.next = pre;
            pre = cur;
            cur = next;
            count++;
        }
        p.next.next = cur;
        p.next = pre;
        return dummy.next;
    }
k个反转链表同上道理,多统计一次长度,加更新p0
class Solution {
    public ListNode reverseKGroup(ListNode head, int k) {
        // 统计节点个数
        int n = 0;
        for (ListNode cur = head; cur != null; cur = cur.next) {
            n++;
        }

        ListNode dummy = new ListNode(0, head);
        ListNode p0 = dummy;
        ListNode pre = null;
        ListNode cur = head;

        // k 个一组处理
        for (; n >= k; n -= k) {
            for (int i = 0; i < k; i++) { // 同 92 题
                ListNode nxt = cur.next;
                cur.next = pre; // 每次循环只修改一个 next,方便大家理解
                pre = cur;
                cur = nxt;
            }

            // 见视频
            ListNode nxt = p0.next;
            p0.next.next = cur;
            p0.next = pre;
            p0 = nxt;
        }
        return dummy.next;
    }
}

作者:灵茶山艾府
链接:https://leetcode.cn/problems/reverse-nodes-in-k-group/solutions/1992228/you-xie-cuo-liao-yi-ge-shi-pin-jiang-tou-plfs/
来源:力扣(LeetCode)
著作权归作者所有。商业转载请联系作者获得授权,非商业转载请注明出处。
链表排序
使用分治思想,递归执行 分成两个链表、两个链表排序、合并有序链表。
需要注意的是,这里的分成两个链表一定要保证能断开,可以用两个节点长度的链表进行实验,进行分割。
要么是在取得中间节点时候多加一个指针pre,然后找到slow之后,pre操作断开。(推荐)
要么就获取前半个末端然后手动断开。代码用的第一种,更加简便。
class Solution {
    public ListNode sortList(ListNode head) {
        // 如果链表为空或者只有一个节点,无需排序
        if (head == null || head.next == null) {
            return head;
        }
        // 找到中间节点 head2,并断开 head2 与其前一个节点的连接
        // 比如 head=[4,2,1,3],那么 middleNode 调用结束后 head=[4,2] head2=[1,3]
        ListNode head2 = middleNode(head);
        // 分治
        head = sortList(head);
        head2 = sortList(head2);
        // 合并
        return mergeTwoLists(head, head2);
    }

    // 876. 链表的中间结点(快慢指针)
    private ListNode middleNode(ListNode head) {
        ListNode pre = head;
        ListNode slow = head;
        ListNode fast = head;
        while (fast != null && fast.next != null) {
            pre = slow; // 记录 slow 的前一个节点
            slow = slow.next;
            fast = fast.next.next;
        }
        pre.next = null; // 断开 slow 的前一个节点和 slow 的连接
        return slow;
    }

    // 21. 合并两个有序链表(双指针)
    private ListNode mergeTwoLists(ListNode list1, ListNode list2) {
        ListNode dummy = new ListNode(); // 用哨兵节点简化代码逻辑
        ListNode cur = dummy; // cur 指向新链表的末尾
        while (list1 != null && list2 != null) {
            if (list1.val < list2.val) {
                cur.next = list1; // 把 list1 加到新链表中
                list1 = list1.next;
            } else { // 注:相等的情况加哪个节点都是可以的
                cur.next = list2; // 把 list2 加到新链表中
                list2 = list2.next;
            }
            cur = cur.next;
        }
        cur.next = list1 != null ? list1 : list2; // 拼接剩余链表
        return dummy.next;
    }
}
多个有序链表合并
这道题目笨办法可以循环逐个进行两两合并的方法,但是更好的办法在于,所有的链表都是有序的可以进行使用堆排序,用优先队列不断维护一个最小节点的堆。每次仅加入头结点(头结点都是最小的)
public ListNode mergeKLists(ListNode[] lists) {
    // 创建优先队列(最小堆),按照节点值升序排列
    PriorityQueue<ListNode> pq = new PriorityQueue<>((a,b) -> a.val - b.val);
    // 将每个链表的头节点(非空)加入优先队列
    for (ListNode node : lists) {
        if (node != null) {
            pq.offer(node);
        }
    }
    ListNode dummy = new ListNode(0);
    ListNode cur = dummy;
    // 当优先队列不为空时,循环处理
    while (!pq.isEmpty()) {
        // 弹出堆顶元素(当前所有链表头节点中的最小值)
        ListNode node = pq.poll();
        // 将最小节点连接到结果链表中
        cur.next = node;
        cur = cur.next;
        // 如果该节点有后续节点,将其加入优先队列
        if (node.next != null) {
            pq.offer(node.next);
        }
    }
    return dummy.next;
}
LRU 缓存
这道题目如果是纯实现要用linkedhashmap,但是算法面试需要自己实现双链表。借用灵神的图和代码。
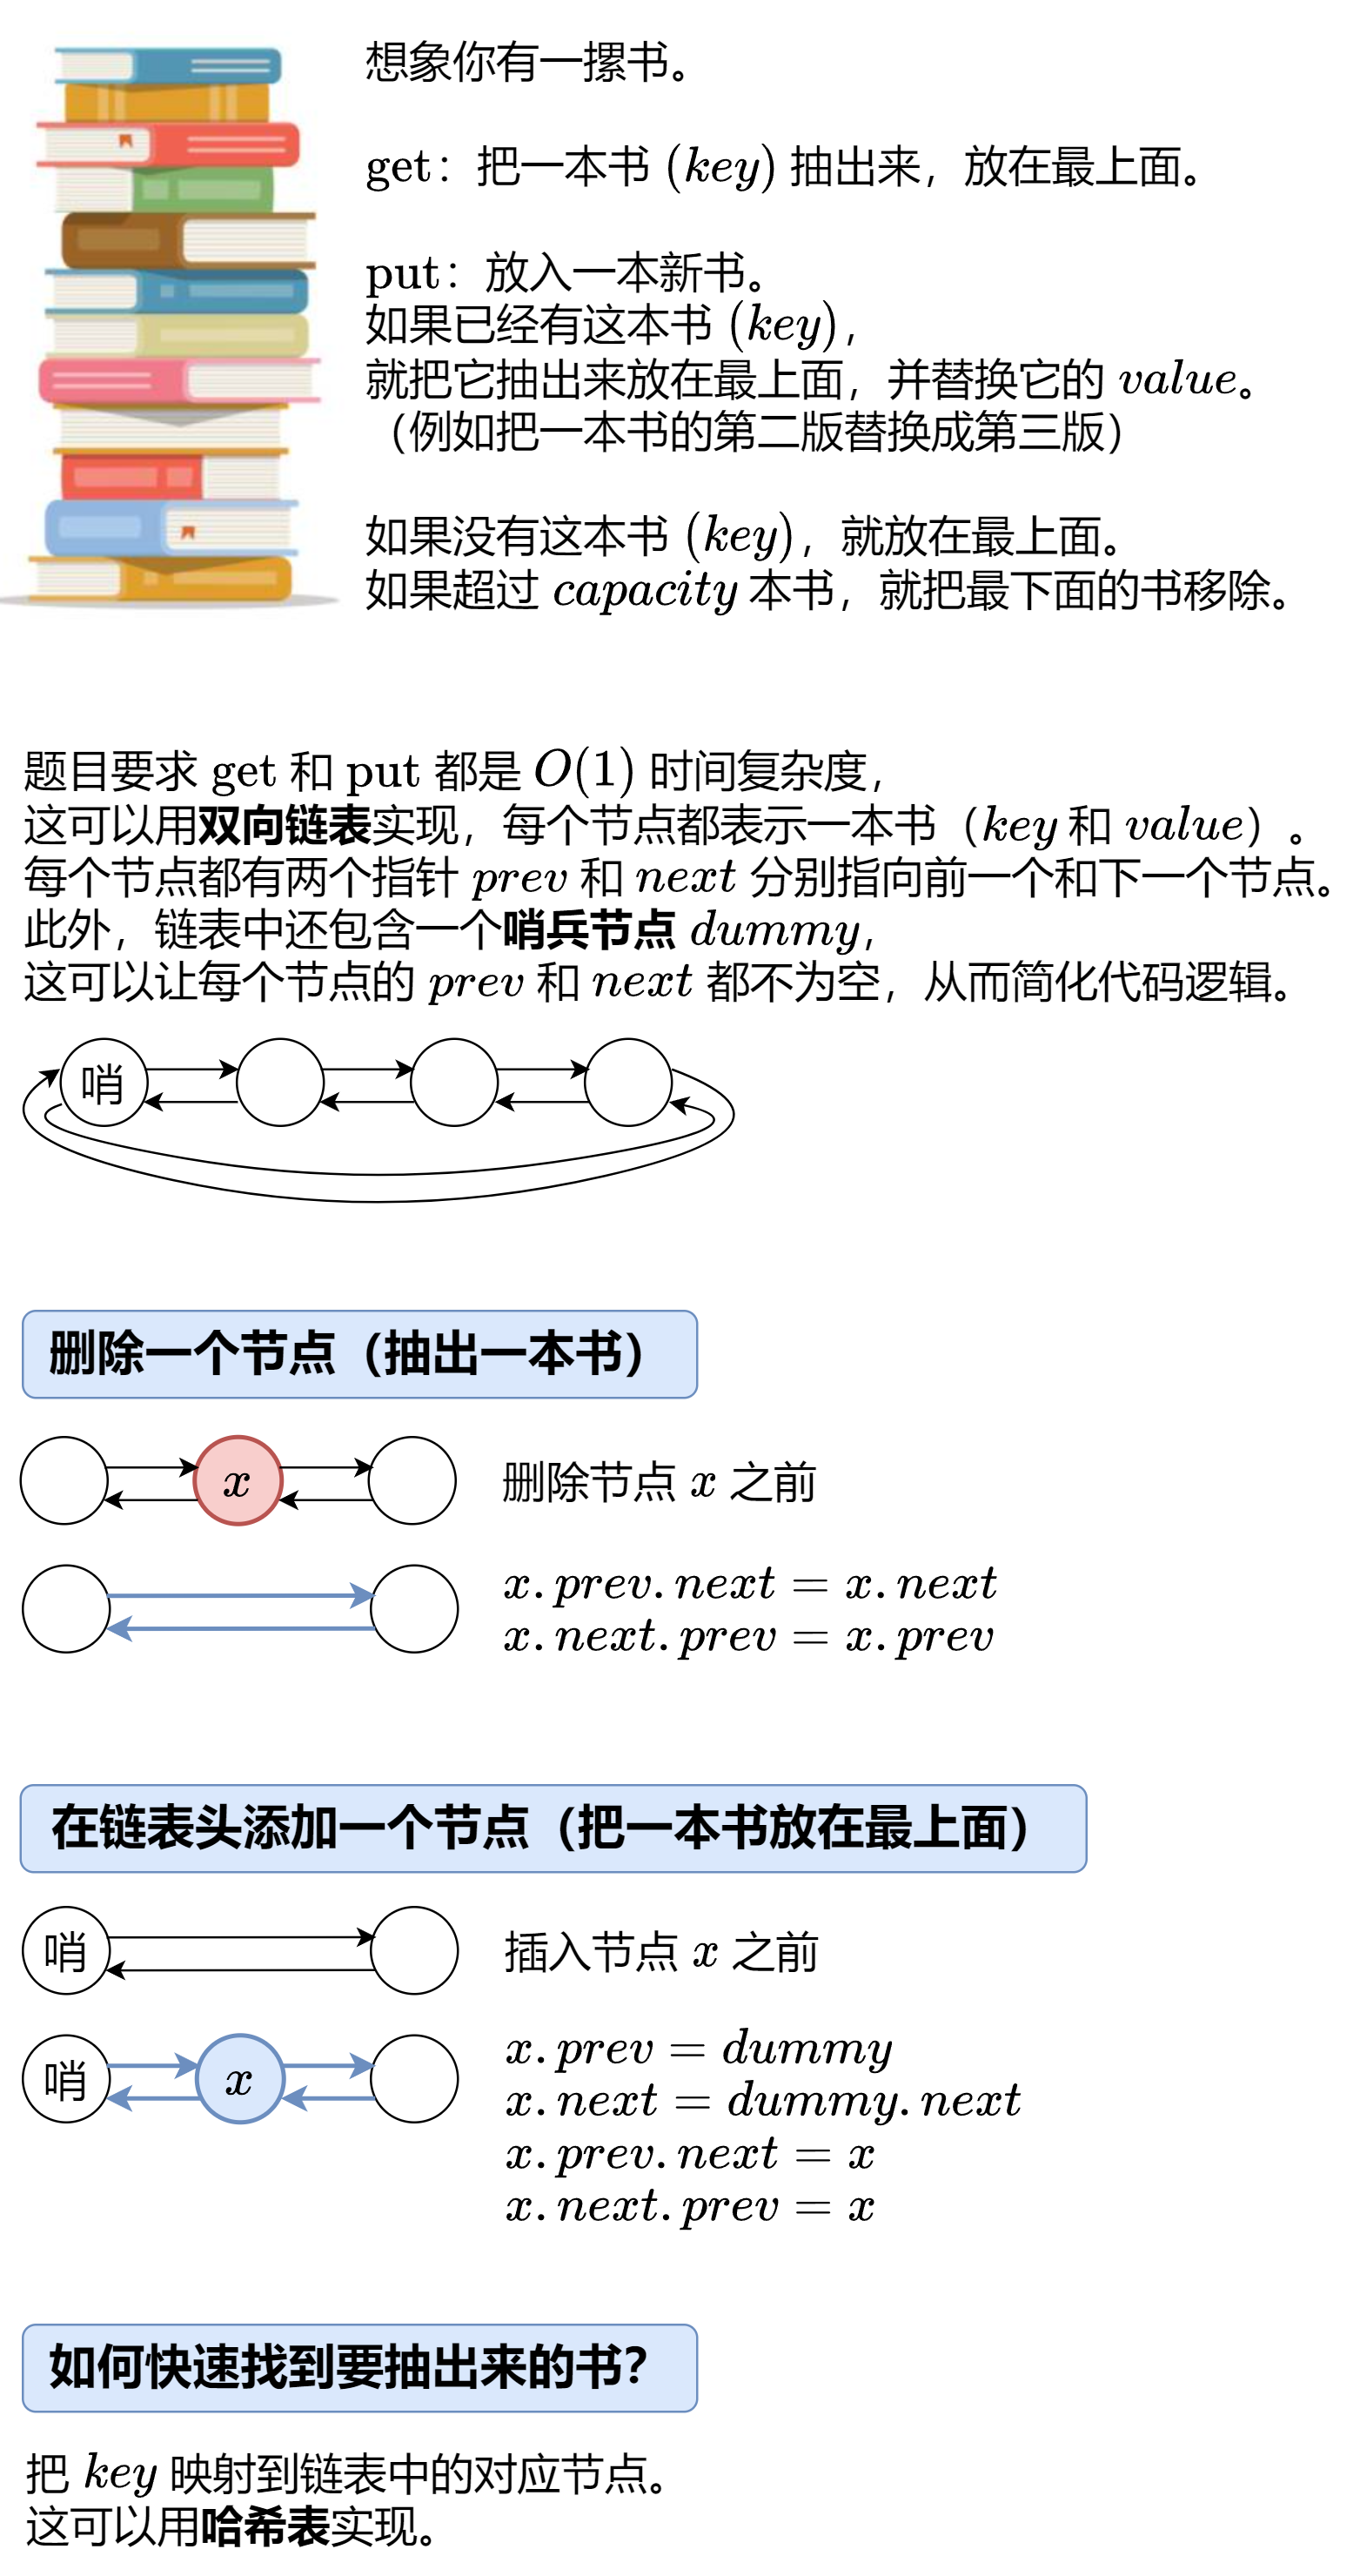
问:需要几个哨兵节点?
答:一个就够了。一开始哨兵节点 dummy 的 prev 和 next 都指向 dummy。随着节点的插入,dummy 的 next 指向链表的第一个节点(最上面的书),prev 指向链表的最后一个节点(最下面的书)。
问:为什么节点要把 key 也存下来?
答:在删除链表末尾节点时,也要删除哈希表中的记录,这需要知道末尾节点的 key。
class LRUCache {
    private static class Node {
        int key, value;
        Node prev, next;

        Node(int k, int v) {
            key = k;
            value = v;
        }
    }

    private final int capacity;
    private final Node dummy = new Node(0, 0); // 哨兵节点
    private final Map<Integer, Node> keyToNode = new HashMap<>();

    public LRUCache(int capacity) {
        this.capacity = capacity;
        dummy.prev = dummy;
        dummy.next = dummy;
    }

    public int get(int key) {
        Node node = getNode(key); // getNode 会把对应节点移到链表头部
        return node != null ? node.value : -1;
    }

    public void put(int key, int value) {
        Node node = getNode(key); // getNode 会把对应节点移到链表头部
        if (node != null) { // 有这本书
            node.value = value; // 更新 value
            return;
        }
        node = new Node(key, value); // 新书
        keyToNode.put(key, node);
        pushFront(node); // 放到最上面
        if (keyToNode.size() > capacity) { // 书太多了
            Node backNode = dummy.prev;
            keyToNode.remove(backNode.key);
            remove(backNode); // 去掉最后一本书
        }
    }

    // 获取 key 对应的节点,同时把该节点移到链表头部
    private Node getNode(int key) {
        if (!keyToNode.containsKey(key)) { // 没有这本书
            return null;
        }
        Node node = keyToNode.get(key); // 有这本书
        remove(node); // 把这本书抽出来
        pushFront(node); // 放到最上面
        return node;
    }

    // 删除一个节点(抽出一本书)
    private void remove(Node x) {
        x.prev.next = x.next;
        x.next.prev = x.prev;
    }

    // 在链表头添加一个节点(把一本书放到最上面)
    private void pushFront(Node x) {
        x.prev = dummy;
        x.next = dummy.next;
        x.prev.next = x;
        x.next.prev = x;
    }
}关于LinkedHashMap
private final Map<Integer, Integer> cache = new LinkedHashMap<>();

public void put(int key, int value) {
    // 如果key已存在,先移除再更新,使其成为最近使用的元素
    if (cache.remove(key) != null) {
        cache.put(key, value);
        return;
    }

    // 如果缓存已满,移除最久未使用的元素(链表头部元素)
    if (cache.size() == capacity) {
        //使用Map的接口和collection接口快速拿到第一个节点
        Integer eldestKey = cache.keySet().iterator().next();
        cache.remove(eldestKey);
    }

    // 添加新元素到缓存(会放在链表末尾)
    cache.put(key, value);
}
继承LinkedHashMap
直接继承的话可以这样用:put方法实际上不需要自己写,因为map本来就有,这里重写了LinkedHashMap的钩子函数,每次put后是否处理最老的一个。
class LRUCache extends LinkedHashMap<Integer, Integer> {
    private static final float DEFAULT_LOAD_FACTOR = 0.75f;
    private final int capacity;

    public LRUCache(int capacity) {
        //第三个参数 true 表示按访问顺序排序
        super(capacity, DEFAULT_LOAD_FACTOR, true);
        this.capacity = capacity;
    }

    public int get(int key) {
        //直接调用父类方法,存在则返回值,LinkedHashMap 会自动将访问过的元素移到末尾
        return super.getOrDefault(key, -1);
    }
	//LinkedHashMap 的钩子方法,每次 put 操作后自动调用,返回 true 时会删除最老元素(链表头部)
    @Override
    protected boolean removeEldestEntry(Map.Entry<Integer, Integer> eldest) {
        return size() > capacity;
    }
}
树
递归返回:如果是自顶向下的,可以没有返回值;如果是自底向上的,就一定要有返回值
「在写递归函数时,可以假设递归返回的结果一定是正确的」。其实这种说法本质上就是数学归纳法。
中序遍历非递归(线索化)

class Solution {
    public List<Integer> inorderTraversal(TreeNode root) {
        List<Integer> ans = new ArrayList<>();

        while (root != null) {
            if (root.left != null) {
                // 找 root 的前驱 pre:在中序遍历中,root 的上一个节点
                // 从 root.left 开始,一直向右走,直到走到尽头,或者遇到指向 root 的线索(回到 root 的路)
                TreeNode pre = root.left;
                while (pre.right != null && pre.right != root) {
                    pre = pre.right;
                }

                // root 的左子树尚未访问
                if (pre.right == null) {
                    pre.right = root; // 建立线索(回到 root 的路),相当于把 pre.right 当作栈
                    root = root.left; // 访问左子树
                    continue;
                }

                // root 的左子树访问完毕,去掉线索,恢复原样
                pre.right = null; // 注:如果调用完 inorderTraversal 不再使用这棵二叉树,这行代码可以去掉
            }

            // root 的左子树访问完毕
            ans.add(root.val); // 记录当前节点的值
            root = root.right; // 如果有右子树就访问右子树,没有就顺着线索回到指向的节点
        }

        return ans;
    }
}
树的直径
求出来子树的最长链路长度然后拼接,全局更新max大小。
重点在于空节点处理,为-1。
//最长路径长度
    int max = 0;
    public int diameterOfBinaryTree(TreeNode root) {
      linkLength(root);
      return max;
    }
//   求root的最长链长度
    public int linkLength(TreeNode root) {
       if (root == null) return -1;//这样如果只有一个根节点,恰好算出来链长是0,对于叶子来说,链长就是 -1+1=0
       int left =  linkLength(root.left)+1;// 左子树最大链长+1(已经考虑了如果左子树为空的情况)
       int right = linkLength(root.right)+1;
       max =  Math.max(max,left+right);//更新max,保证max拿到全局最长的直径
       return Math.max(left,right);//返回当前子树的最大链长
    }
层次遍历java版本
两个list或者一个队列。
以前c语言还需要计算层数和加到层数到结构体,这里没那么麻烦,现成的队列然后计算每层的数量,用循环控制层数。
class Solution {
    public List<List<Integer>> levelOrder(TreeNode root) {
        if (root == null) {
            return List.of();
        }
        List<List<Integer>> ans = new ArrayList<>();
        Queue<TreeNode> q = new ArrayDeque<>();
        q.add(root);
        while (!q.isEmpty()) {
            int n = q.size();
            List<Integer> vals = new ArrayList<>(n); // 预分配空间
            while (n-- > 0) {//这里提前计算每一层的数量,然后仅仅遍历这几次保证只拿到这一层的
                TreeNode node = q.poll();
                vals.add(node.val);
                if (node.left != null)  q.add(node.left);
                if (node.right != null) q.add(node.right);
            }
            ans.add(vals);
        }
        return ans;
    }
}

//数组版本
    public List<List<Integer>> levelOrder(TreeNode root) {
        if (root == null) {
            return new ArrayList<>(); // 替代 List.of()
        }
        List<List<Integer>> ans = new ArrayList<>();//结果数组
        List<TreeNode> cur = new ArrayList<>(); //当前层节点数组
        cur.add(root);

        while (!cur.isEmpty()) {
            List<TreeNode> nxt = new ArrayList<>();
            List<Integer> vals = new ArrayList<>(cur.size());
            for (TreeNode node : cur) {
                vals.add(node.val);
                if (node.left != null)  nxt.add(node.left);
                if (node.right != null) nxt.add(node.right);
            }
            cur = nxt;
            ans.add(vals);
        }
        return ans;
    }
给定二叉树数组构建二叉搜索树
核心在于拆分递归。中间节点为根节点,左右两侧数组都是子树。终止条件是如果数组为空就返回null。
这里要注意递归的边界,题解写法是左闭右开,这里代码是左闭右闭,因此终止条件要写left大于right。
    public TreeNode sortedArrayToBST(int[] nums) {
        return buildTree(nums, 0, nums.length - 1);
    }

    public TreeNode buildTree(int[] nums, int left, int right) {
        if (left > right) {
            return null;
        }
        int mid = left + (right - left) / 2;
        TreeNode node = new TreeNode(nums[mid]);
        node.left = buildTree(nums, left, mid - 1);
        node.right = buildTree(nums, mid + 1, right);
        return node;
    }
验证二叉搜索树
这里用的是前序遍历。核心在于每个节点都有一个大小区间。初始化区间是最大和最小极值,然后从验证根节点是否符合条件,再验证左右子树是否符合条件。验证左右子树的时候根据搜索树的性质传出对应的最大or最小值,另一个是原本的参数值。
public boolean isValidBST(TreeNode root) {
        return isValidBST2(root, Long.MIN_VALUE, Long.MAX_VALUE);
    }

    public  boolean isValidBST2(TreeNode root,long min, long max) {
        if (root == null) {
            return true;
        }
        if (root.val <= min || root.val >= max) {
            return false;
        }
        return isValidBST2(root.left, min, root.val) && isValidBST2(root.right, root.val, max);

    }
如果用中序遍历就得记录一下pre,然后不断比较pre和根节点的值。
二叉树右视图
两个方法,简单就层序遍历记录每层最后一个节点的值,另一个方法是递归,根-右子树-左子树,并传递depth参数,知道是否新到一层,直接将根节点值加入答案中。
递归的核心是,ans.size值恰好为下一个要加的元素是第几个(第几层),传参depth与之相等时候就说明是这层的最右侧的节点,可以加入ans。
//递归

    public List<Integer> rightSideView(TreeNode root) {
        List<Integer> ans = new ArrayList<>();
        dfs(root, 0, ans);
        return ans;
    }

    private void dfs(TreeNode root, int depth, List<Integer> ans) {
        if (root == null) {
            return;
        }
        if (depth == ans.size()) { // 这个深度首次遇到
            ans.add(root.val);
        }
        dfs(root.right, depth + 1, ans); // 先递归右子树,保证首次遇到的一定是最右边的节点
        dfs(root.left, depth + 1, ans);
    }

//层次遍历:
public List<Integer> rightSideView(TreeNode root) {
        List<Integer> ans = new ArrayList<>();
        if (root == null) return ans;//这里一定要注意排除根节点为空的情况,否则下面cur.getLast会报错
        List<TreeNode> cur = new ArrayList<>();
        List<TreeNode>nxt = new ArrayList<>();
        cur.add(root);
        while (!cur.isEmpty()) {
            //每层遍历
            //这层要做的事,添加最后一个不为空的节点
            ans.add(cur.getLast().val);
            for (TreeNode node : cur) {
                if (node.left != null) {
                    nxt.add(node.left);
                }
                if (node.right != null) {
                    nxt.add(node.right);
                }
            }
            cur = nxt;
            nxt = new ArrayList<>();
        }
        return ans;
    }
二叉树展开为链表
//递归,分治,返回当前展开链表的尾结点。根节点拿到左子树的链表尾结点可以和右子树链表的根节点连接。
    public void flatten(TreeNode root) {
        dfs(root);
    }

    private TreeNode dfs(TreeNode root) {
        if (root == null) {
            return null;
        }
        TreeNode leftTail = dfs(root.left);
        TreeNode rightTail = dfs(root.right);
        if (leftTail != null) {
            leftTail.right = root.right; // 左子树链表 -> 右子树链表
            root.right = root.left; // 当前节点 -> 左右子树合并后的链表
            root.left = null;
        }//返回值是尾结点,这里实际分情况看尾结点是谁,有右子树尾结点就右子树尾结点,否则左,否则根
        return rightTail != null ? rightTail : leftTail != null ? leftTail : root;
    }

//递归,头插法,实际上是展开之后更新展开链表的头结点,然后按照题目的顺序进行头插(头插顺序为右-左-根),需要全局变量head。头插之后更新head
 TreeNode head;
    public void flatten(TreeNode root) {
        if (root == null) return;
        flatten(root.right);
        flatten(root.left);
        root.left = null;
        root.right = head;
        head = root;
    }
//笨办法,也是递归,尾插法,相比第一种得手动找尾结点
public void flatten(TreeNode root) {
        if (root == null) return;
        flatten(root.left);
        flatten(root.right);
        if (root.left != null) {
            TreeNode right = root.right;
            root.right = root.left;
            root.left = null;
            TreeNode p = root.right;
            while (p.right != null) {//找尾结点
                p = p.right;
            }
            p.right = right;
        }
    }
中序先序确定二叉树
这里注意用java的数组的复制语法就可以,左闭右开记得。
  public TreeNode buildTree( int[] preorder, int[] inorder) {
        if (preorder.length==0 || inorder.length==0) {
            return null;
        }
        TreeNode root = new TreeNode(preorder[0]);
        int inRootIndex = 0;
        for (int i = 0; i <= inorder.length; i++) {
            if (inorder[i] == preorder[0]) {
                inRootIndex = i;
                break;
            }
        }
        int [] leftPreOrder = Arrays.copyOfRange(preorder, 1, inRootIndex + 1);//这里是因为数值恰好相等才用的
        int [] leftInOrder = Arrays.copyOfRange(inorder, 0, inRootIndex );
        int [] rightPreOrder = Arrays.copyOfRange(preorder, inRootIndex + 1, preorder.length);
        int [] rightInOrder = Arrays.copyOfRange(inorder, inRootIndex + 1, inorder.length);
        root.left = buildTree(leftPreOrder, leftInOrder);
        root.right = buildTree(rightPreOrder,rightInOrder);
        return root;
    }
树的路径总和III
(https://leetcode.cn/problems/subarray-sum-equals-k/description/) 437. 路径总和 III - 力扣(LeetCode)
这道题目应该和前缀和(560. 和为 K 的子数组)一起看,原理依旧是维护一个前缀和,然后遍历路径上的时候使用map查询,如果有就相加。并同时添加和的key到map中。但是这里用的是递归所以需要记得回退map,由于sum是递归传参不需要回退(其他分支是不影响的)
class Solution {
   int res = 0;
   Map<Long, Integer> map = new HashMap<>();
    // map用来存放当前递归分支上已经出现过的前缀和。注意节点的取值范围要使用Long

   public int pathSum(TreeNode root, int targetSum) {
       map.put(0L, 1);  // 注意先在map中放入0,不然当前缀和正好等于 targerSum 时没法被计入 res。注意这里要做 int -> Long 的类型转换
       traversal(root, targetSum, 0L); // 这里也要做 int -> Long 的类型转换
       return res;
   }

   public void traversal(TreeNode node, int targetSum, Long sum){  // 由于节点值的范围是Long,所以节点的和的类型也应该是Long
       // 参数sum表示前缀和(从根节点到当前节点的所有节点之和)
       if(node==null) return ;

       sum += node.val;
       if(map.containsKey(sum-targetSum)){
           res += map.get(sum-targetSum);
       }
       map.put(sum, map.getOrDefault(sum, 0)+1);

       traversal(node.left, targetSum, sum);   // sum不能是全局变量,而必须是递归函数的参数。否则在这里向左递归后,sum的值的变化会影响到接下来向右递归时sum的大小
       traversal(node.right, targetSum, sum);

       // 回溯。因为sum是递归函数参数,每个递归分支的sum之间互相独立,所以不用再手动回溯sum的值,只需要手动回溯map就够了
       map.put(sum, map.get(sum)-1);
   }
}
最近公共祖先
这里推荐使用递归做法,自己原本想的是找路径然后对比(也是递归只不过需要维护路径)。
返回值的准确含义是「最近公共祖先的候选项」。对于最外层的递归调用者来说,返回值是最近公共祖先的意思。但是,在递归过程中,返回值可能是最近公共祖先,也可能是空节点(表示子树内没找到任何有用信息)、节点 p 或者节点 q(可能成为最近公共祖先,或者用来辅助判断上面的某个节点是否为最近公共祖先)。如果下面有 q 或者 p,那么当前节点就是最近公共祖先,直接返回当前节点。如果下面没有 q 和 p,那既然都没有要找的节点了,也不需要递归,直接返回当前节点。
class Solution:
    def lowestCommonAncestor(self, root: 'TreeNode', p: 'TreeNode', q: 'TreeNode') -> 'TreeNode':
        if root in (None, p, q):  # 找到 p 或 q 就不往下递归了,原因见上面答疑
            return root
        left = self.lowestCommonAncestor(root.left, p, q)
        right = self.lowestCommonAncestor(root.right, p, q)
        if left and right:  # 左右都找到
            return root  # 当前节点是最近公共祖先
        # 如果只有左子树找到,就返回左子树的返回值
        # 如果只有右子树找到,就返回右子树的返回值
        # 如果左右子树都没有找到,就返回 None(注意此时 right = None)
        return left or right
//笨办法
 public TreeNode lowestCommonAncestor01(TreeNode root, TreeNode p, TreeNode q) {
        List <TreeNode> pathP = new LinkedList<>();
        List <TreeNode> pathQ = new LinkedList<>();
        dfsPath( root, p,pathP);
        dfsPath( root, q,pathQ);
        int length = Math.min(pathP.size(), pathQ.size());
        for (int i = 0; i < length ; i++) {
            if (pathP.get(i) != pathQ.get(i)) {
                return pathP.get(i-1);
            }
        }
        return pathP.get(length-1);
    }
    public void dfsPath(TreeNode root, TreeNode p,List<TreeNode> path){
        if (root == null) return ;
        path.add(root);
        if (root == p) return ;
        dfsPath(root.left,p,path);
        dfsPath(root.right,p,path);
        if (path.getLast() != p) {
            path.removeLast();//回溯
        }
    }
最大路径之和
这道题目和前面的最大直径路径 是一样的套路,实际上我们都需要去枚举拐点,将最大的拆分成左右两边最大来进行计算。不同点在于,最大直径那里边界条件为空的时候需要判-1(这样和后面抵消),而这里需要判0(因为是和)。
- 最大最小值用Integer的最大和最小值
- 定义全局变量,和递归的返回结果不同所以单独写递归然后调用
- 注意最终递归返回值的话需要考虑和0 的关系,即当前树的最大路径值和与0的关系
Integer ansMaxSum = Integer.MIN_VALUE;
    public int maxPathSum(TreeNode root) {
        dfsMaxPathSum(root);
        return ansMaxSum;
    }
//这个递归是用来求当前树的最大的路径和(根节点出发)
    public int dfsMaxPathSum(TreeNode root) {
        if (root == null) return 0;
        int left =  dfsMaxPathSum(root.left);
        int right = dfsMaxPathSum(root.right);
        ansMaxSum = Math.max(left+right+root.val,ansMaxSum);//拐点进行判断,就可以取得全局的最大,可能不过根节点。
        return Math.max(Math.max(left,right)+root.val,0);
    }
二分搜索
在排序数组中查找元素的第一个和最后一个位置
二分搜索法和普通循环法
二分搜索需要关注区间,答案在区间外面而不在区间里。这里要求的start实际上是在left和right的外面的,最后一次循环left等于right后,left会越过right,到达区间外面的答案的位置,此时正好跳出循环。
二分法的心法(选一个牢记就行)
首先确定写哪种,这里我掌握了闭区间和开区间的写法。可用红蓝染色法理解,不变量是 left、right 的两侧始终符合初始定义的规则(与目标值的大小关系),全程不破坏,循环结束即得答案。
- 闭区间:left 左侧(不含 left)满足红区规则,right 右侧(不含 right)满足蓝区规则(示例:红区 < target,蓝区≥target)
- 初始值为 0 和数组长度 - 1,覆盖整个数组
- 转移公式为 mid+1 或 mid-1,mid 已判断需排除出未探索区间
- 终止条件是 left>right(未探索区间为空),循环中 left≤right 持续执行;找第一个蓝区元素取 left,找最后一个红区元素取 right
- 开区间:left 及左侧满足红区规则,right 及右侧满足蓝区规则(示例:红区 < target,蓝区≥target)
- 初始值为 - 1 和数组长度,覆盖整个数组
- 转移公式为 mid,left/right 为开区间边界,mid 判断后可直接作为新边界
- 终止条件是 left+1=right(区间无未探索元素),循环中 left+1<right 持续执行;找第一个蓝区元素取 right,符合开区间不变量规则
二分法函数写完,调用的时候也要记得区分:如果数组里面不包含target,那么返回值有两种情况:
如果不存在target可能因为全小于target而指向length位置
也还可能指向某一个位置就结束
因此需要对这两种情况单独判断,符合就直接返回结果。
求末尾位置 = target+1初始位置-1
class Solution {
    public int[] searchRange(int[] nums, int target) {
        int start = lowerBound(nums, target);
        //这里的start如果不存在target可能因为全小于target而指向length位置,也还可能指向某一个位置结束
        if (start == nums.length || nums[start] != target) {
            return new int[]{-1, -1}; // nums 中没有 target
        }
        // 如果 start 存在,那么 end 必定存在
        int end = lowerBound(nums, target + 1) - 1;
        return new int[]{start, end};
    }

    //闭区间写法
    // lowerBound 返回最小的满足 nums[i] >= target 的下标 i
    // 如果数组为空,或者所有数都 < target,则返回 nums.length
    // 要求 nums 是非递减的,即 nums[i] <= nums[i + 1]
    private int lowerBound(int[] nums, int target) {
        int left = 0;
        int right = nums.length - 1; // 闭区间 [left, right]
        while (left <= right) { // 区间不为空
            // 循环不变量:
            // nums[left-1] < target
            // nums[right+1] >= target
            int mid = left + (right - left) / 2;
            if (nums[mid] >= target) {
                right = mid - 1; // 范围缩小到 [left, mid-1]
            } else {
                left = mid + 1; // 范围缩小到 [mid+1, right]
            }
        }
        // 循环结束后 left = right+1
        // 此时 nums[left-1] < target 而 nums[left] = nums[right+1] >= target
        // 所以 left 就是第一个 >= target 的元素下标
        return left;
    }
}

//开区间写法
public int findFirst(int []nums,int target){
        int left = -1;
        int right = nums.length;
        while(left+1<right){
            int mid  = left + (right-left)/2;
            if(nums[mid]>=target){
                right = mid;
            }else {
                left = mid;
            }
        }
        return right;
    }
旋转数组中的最小值
旋转数组特性
旋转排序数组拆分后的左段(旋转前半段)所有元素 > 数组最后一个元素,右段(旋转后半段,含最小值)所有元素 ≤ 数组最后一个元素,且两段内部均为升序。
因此用target和末尾元素的大小关系,能O (1) 时间直接锁定 target 的唯一可能存在区间,避免了对两段区间的逐一遍历,完美契合二分法的高效性要求。
首先找旋转数组的最小值位置。
闭区间表示【left,right】都没有探索。开区间表示【left+1,right-1】没有探索!终点是区间内没有探索元素,闭区间就是left>right,开区间就是left和righ相邻(因为开区间的区间内容不包含left和right端点本身)
闭区间二分核心:不变量贯穿全程,始终保持左/右已探索区规则固定,未探索区为严格闭区间[left, right],不破坏则循环结束得正确答案
- 初始值规则:闭区间覆盖全部未探索区域,固定left=0、right=数组长度-1,未探索区初始为[0,n-1],包含所有元素
- 循环条件规则:未探索区非空时持续循环,固定while (left <= right),left<=right时[left,right]为非空未探索区,left>right则空、循环终止
- 转移公式规则:mid已探索必须排除出未探索区,仅用left=mid+1或right=mid-1,保证新未探索区[left,right]为纯未探索区域;本题nums[mid]>nums[n-1]则left=mid+1,nums[mid]≤nums[n-1]则right=mid-1
- 不变量核心定义:左/右已探索区规则固定,未探索区逐步缩小;本题左已探索区[0,left-1]全>nums[n-1],右已探索区[right+1,n-1]全≤nums[n-1],未探索区[left,right]为待判断区域,每次二分仅缩小、不破坏规则
- 循环终止规则:终止时未探索区为空,且left=right+1;循环结束必满足left>right,未探索区消失,所有元素划入已探索区
- 答案取值规则:找第一个符合蓝区规则的元素取left,left是蓝区第一个位置;本题蓝区规则为≤nums[n-1],left指向最小值索引,返回nums[left]
class Solution {
    //闭区间写法
  public int findMin(int[] nums) {
        int left = 0;
        int right = nums.length - 1;
        while (left <= right) {
            int mid  = left + (right-left)/2;
            if (nums[mid] > nums[nums.length - 1]) {//这里要始终和数组的末尾比较
                left = mid + 1;
            }else {
                right = mid-1;
            }
        }
        return left;//有道题目就是找旋转数组最小值,这里访问left的值就行nums[left]
    }
}
//开区间写法
public int findMin(int[] nums) {
        int left = -1;//开区间定义初始值就要在数值区间增加一个
        int right = nums.length;//开区间定义初始值就要在数值区间增加一个
        while (left +1< right) {//红蓝染色终点是left+1=right。开区间没有探索元素
            int mid  = left + (right-left)/2;
            if (nums[mid] > nums[nums.length-1]) {
                left = mid;
            }else {
                right = mid;
            }
        }
        return nums[right];
    }
搜索旋转数组
这里应用了之前写的代码,首先先找到旋转数组中的最小的位置。然后,比较target和末尾元素值,确定在哪段进行二分,其次,写一个简单的二分法分别调用两次在两个区间中进行比较。
这里用比较target和末尾元素值来确定在哪个区间用二分很巧妙,这样如果minidx为0或者1,一定存在有一个区间是空区间,但是二分法中有严格的区间机制,空区间会自动结束的!(二分法的严格区间机制会让空区间自动结束循环,无需额外处理 —— 这正是闭区间(及开区间)二分法的天然优势,也是代码无需冗余边界判断的根本原因。)
//全部开区间写法(推荐)
public int findMinIndex(int[] nums) {
        int left = -1;
        int right = nums.length;
        while (left +1< right) {
            int mid  = left + (right-left)/2;
            if (nums[mid] > nums[nums.length-1]) {
                left = mid;
            }else {
                right = mid;
            }
        }
        return right;
    }
    public int search(int[] nums, int target) {
        int min = findMin(nums);
        if(target > nums[nums.length-1]){
            //target在第一段
           int leftRes = lowerBound(nums,target,-1,min);
            if (leftRes == min || nums[leftRes] != target) {
                return -1;
            }
            return leftRes;
        }else  {
            int rightRes = lowerBound(nums,target,min-1,nums.length);
            if (rightRes == nums.length || nums[rightRes] != target) {
                return -1;
            }
            return rightRes;
        }
    }
    //开区间写法
    public int lowerBound(int []nums, int target,int left,int right) {
        while (left+1 < right) {
            int mid = left + (right - left) / 2;
            if (nums[mid] >= target) {
                right = mid;
            } else {
                left = mid;
            }
        }
        return right;
    }


//全部闭区间写法
class Solution {
    // 闭区间找旋转数组最小值的索引(核心:找第一个≤nums[n-1]的位置)
    public int findMinIndex(int[] nums) {
        int left = 0;
        int right = nums.length - 1;
        while (left <= right) {
            int mid = left + (right - left) / 2;
            if (nums[mid] > nums[nums.length - 1]) {
                left = mid + 1; // mid在左段,收缩左边界
            } else {
                right = mid - 1; // mid在右段,收缩右边界
            }
        }
        return left; // 循环结束left指向最小值索引
    }

    public int search(int[] nums, int target) {
        int minIdx = findMinIndex(nums);
        int n = nums.length;
        if (target > nums[n - 1]) {
            // target在左段[0, minIdx-1],闭区间二分查找
            int res = lowerBoundClose(nums, target, 0, minIdx - 1);
            return (res <= minIdx - 1 && nums[res] == target) ? res : -1;
        } else {
            // target在右段[minIdx, n-1],闭区间二分查找
            int res = lowerBoundClose(nums, target, minIdx, n - 1);
            return (res < n && nums[res] == target) ? res : -1;
        }
    }

    // 闭区间版lowerBound:在[left, right]范围内找第一个≥target的索引
    // 闭区间规则:初始[L,R]、循环left<=right、转移mid±1、返回left
    public int lowerBoundClose(int[] nums, int target, int L, int R) {
        int left = L;
        int right = R;
        while (left <= right) {
            int mid = left + (right - left) / 2;
            if (nums[mid] >= target) {
                right = mid - 1; // 目标在左半段,收缩右边界
            } else {
                left = mid + 1; // 目标在右半段,收缩左边界
            }
        }
        return left; // 循环结束left指向第一个≥target的位置
    }
}
寻找两个有序数组的中位数(hard,最难了直接背)
不合并数组,通过划分数组找中位数:将两个有序数组合法划分为左右两半区,左半区总元素数≥右半区,且左半区所有数≤右半区所有数,此时奇数取左半区最大值,偶数取左右半区最值平均值。
合法划分要求
- 左半区 = nums1 前 i 个 + nums2 前 j 个;右半区 = nums1 剩余 + nums2 剩余;
- 核心公式绑定 i/j:
j = (m+n+1)/2 - i,保证左半区元素数符合中位数要求; - 合法条件:
a[i] ≤ b[j+1] && a[i+1] > b[j],保证左右半区有序。
步骤 1:短数组前置
- 逻辑:将更短的数组设为 nums1,长数组为 nums2,减少后续枚举次数,规避边界问题。
步骤 2:构建哨兵数组
- 逻辑:为两原数组各建新数组(长度 = 原长 + 2),首位置负无穷、末位置正无穷作哨兵,避免划分点在首尾时越界;原数组元素拷贝至新数组 1~ 原长度索引处。
步骤 3:初始化划分点
- 逻辑:i 是 nums1 放入左半区的元素数,j 是 nums2 放入左半区的元素数;用公式
j=(m+n+1)/2 -i(m、n 为两原数组长度)绑定 i 和 j,保证左半区元素数符合中位数取值要求。
- 逻辑:i 是 nums1 放入左半区的元素数,j 是 nums2 放入左半区的元素数;用公式
步骤 4:枚举找合法划分
- 逻辑:i 从 0 开始枚举,不满足合法条件则 i++、j–;合法条件为
a[i] ≤ b[j+1] 且 a[i+1] > b[j](a、b 为哨兵数组),满足则进入中位数计算。
- 逻辑:i 从 0 开始枚举,不满足合法条件则 i++、j–;合法条件为
步骤 5:计算并返回中位数
- 逻辑:取 a、b 左半区最后一个数的最大值,作为整体左半区全局最大值;取 a、b 右半区第一个数的最小值,作为整体右半区全局最小值;总长度奇数返回左半区最大值,偶数返回左右半区最值的平均值。
//寻找两个正序数组的中位数-hard,直接背吧
    public double findMedianSortedArrays(int[] nums1, int[] nums2) {
        if (nums1.length > nums2.length) {
            int [] temp = nums1;
            nums1 = nums2;
            nums2 = temp;
        }
        int m = nums1.length;
        int n = nums2.length;
        int []a = new int[m+2];
        int []b = new int[n+2];
        a[0] = b[0] = Integer.MIN_VALUE;
        a[m+1] = b[n+1] = Integer.MAX_VALUE;
       System.arraycopy(nums1, 0, a, 1, m);
       System.arraycopy(nums2, 0, b, 1, n);
       int i = 0;
       int j = (m+n+1)/2-i;
       while(true){
           if (a[i+1]>b[j] && a[i]<=b[j+1] ) {
               //找到了
               int max1 = Math.max(a[i], b[j]);
               int min2 = Math.min(a[i + 1], b[j + 1]);
               return (m + n) % 2 > 0 ? max1 : (max1 + min2) / 2.0;
           }
           i++;
           j--;
       }
    }
栈
有效的括号
这题目比较简单,主要是学习写法。
- 额外过滤:奇偶判断,如果是奇数肯定不可能都配对
- java中初始化栈要用Deque(这里用具体的类ArrayDeque)
- 这里直接pop就行,初始化map也可以用匿名类初始化(不重要)
- 最后栈如果不为空肯定不是配对的
class Solution {
    public boolean isValid(String s) {
        if (s.length() % 2 != 0) { // s 长度必须是偶数
            return false;
        }
        Map<Character, Character> mp = new HashMap<>() {{
            put(')', '(');
            put(']', '[');
            put('}', '{');
        }};
        Deque<Character> st = new ArrayDeque<>();
        for (char c : s.toCharArray()) {
            if (!mp.containsKey(c)) { // c 是左括号
                st.push(c); // 入栈
            } else if (st.isEmpty() || st.pop() != mp.get(c)) { // c 是右括号
                return false; // 没有左括号,或者左括号类型不对
            }
        }
        return st.isEmpty(); // 所有左括号必须匹配完毕
    }
}
单调栈
获取最小数的栈
需要的结果是单调性的,用辅助栈保存单调结果。辅助的单调栈数量可以不用和主栈保持一致,只需要在关键节点时候进行比较更新保证结果正确。这里获取最小值的时候,只需要保存小于等于当前最小值的元素即可。
public class MinStack {
    private Deque<Integer> stack;
    private Deque<Integer> min_stack;
    public MinStack() {
        this.min_stack = new ArrayDeque<>();
        this.stack = new ArrayDeque<>();
    }
    public void push(int val) {
        stack.push(val);
        if (min_stack.isEmpty()||val <= min_stack.peek()) {
            min_stack.push(val);
        }
    }
    public void pop() {
       int val =  this.stack.pop();
         if(!min_stack.isEmpty() && val == min_stack.peek()){
              min_stack.pop();
         }
    }
    public int top() {
        if (stack.isEmpty()) {
            return -1;
        }
        return this.stack.peek();
    }
    public int getMin() {
        if (min_stack.isEmpty()) {
            return -1;
        }
        return this.min_stack.peek();
    }
}
//每日温度-单调栈,栈顶元素是当前还没有找到更高温度的索引,遇到更高温度时出栈并计算差值
public int[] dailyTemperatures(int[] temperatures) {
Deque<Integer> s = new ArrayDeque<>();
int []res = new int[temperatures.length];
for (int i = 0; i < temperatures.length; i++) {
while(!s.isEmpty() && temperatures[i]>temperatures[s.peek()]){
int j = (int) s.pop();
res[j] = i-j;
}
s.push(i);
}
return res;
}栈内元素最终都处理:
- 能找到更高温度的元素:会在后续遍历中被弹出栈,更新
res[j]; - 找不到更高温度的元素:会一直留在栈里,
res[j]保持默认值0(符合题目要求);
最大矩形面积
//最大矩形面积-单调栈,栈顶元素是当前还没有找到更小高度的索引,遇到更小高度时出栈并计算以出栈元素为高度的矩形面积
    public int largestRectangleArea(int[] heights) {
        //先找left数组
        int []left = new int[heights.length];
        Deque<Integer>s = new ArrayDeque<>();
        for (int i = 0; i < heights.length; i++) {
            while(!s.isEmpty() &&heights[s.peek()] >= heights[i] ){
                //我们要找小于的值,所以当栈顶元素大于等于当前元素时出栈,直到找到小于当前元素的值或者栈空
                s.pop();
            }
           left[i] = s.isEmpty()?-1:s.peek();
            s.push(i);//无论如何都要把当前元素的索引入栈,因为它可能是后面元素的left边界
            }

        //再找right数组
        int []right = new int[heights.length];
        s.clear();
        for (int i = heights.length-1; i >=0; i--) {
            while(!s.isEmpty() &&heights[s.peek()] >= heights[i] ){
                //我们要找小于的值,所以当栈顶元素大于等于当前元素时出栈,直到找到小于当前元素的值或者栈空
                s.pop();
            }
            right[i] = s.isEmpty()?heights.length:s.peek();
            s.push(i);//无论如何都要把当前元素的索引入栈,因为它可能是后面元素的left边界
        }
        //最后计算面积
        int maxArea = 0;
        for (int i = 0; i < heights.length; i++) {
            int area = heights[i]* (right[i]-left[i]-1);//它们之间的元素都是大于等于当前元素的,宽度就是它们之间的距离减去1
            maxArea = Math.max(maxArea, area);
        }
        return maxArea;
}也可以优化成两次遍历,left和right一起求出来。此时right的定义会发生变化,right[i] = 右侧第一个小于等于 heights[i] 的下标。
这样代码中可以这样同时求right和left
//right初始化:Arrays.fill(right, n);
while (!st.isEmpty() && heights[st.peek()] >= h) {
                right[st.pop()] = i;
            }
            left[i] = st.isEmpty() ? -1 : st.peek();
            st.push(i);
这样做的原因是,right的定义改变,但是left定义不变,所以如果有两个柱子高度都是最优解时候,右侧的柱子计算出来的面积还是正确的最大的面积的。
递归解码字符串
    public String decodeString(String s) {
       return decode(s.toCharArray());
    }
    private int decodeIndex = 0;
    //这里一定要用字符串数组参数而不是string,因为递归之后要处理一个字符串的子串
    public String decode(char[] s){
        int k = 0;
        StringBuilder res = new  StringBuilder();

        while(decodeIndex<s.length){
            char c = s[decodeIndex];
            decodeIndex++;
            if (Character.isLetter(c)){
                res.append(c);
            } else if (Character.isDigit(c)) {
                k = k*10 + (c - '0');//数字可能有多位,所以每次都要乘以10加上当前位的数字
            } else if (c=='['){
                String sub = decode(s);//递归解码右侧的字符串
                res.append(sub.repeat(k));
                k = 0;//重置k,准备下一轮的数字,否则如果有连续的数字,比如3[a]2[bc],当解码完3[a]后,k已经是3了,如果不重置k,那么解码2[bc]的时候就会变成32[bc]
            }else {
                break;
            }
        }
        return res.toString();
    }
图论
能否上完课程(判断环)
public boolean canFinish(int numCourses, int[][] prerequisites) {
//初始化邻接表
    List<Integer>[] graph = new ArrayList[numCourses];
    Arrays.setAll(graph,i->new ArrayList<>());
    for (int i = 0; i < prerequisites.length; i++) {
        graph[prerequisites[i][1]].add(prerequisites[i][0]);
     }
    int []color = new int[numCourses];

    //开始判断有没有环
    for (int i = 0; i < numCourses; i++) {
        if (color[i] == 0) {//如果没有访问过,就开始访问,如果访问过了,就不需要访问了,包含了color[i]==2的情况
            if (dfsCourse(graph,color,i)) {
                return false;
            }
        }
    }
    return  true;
}
//如果返回true表示有环,这里注意一定要递归保持一致,如果是返回false表示有环,那么递归函数就要在有环的时候返回false,条件判断出问题
public boolean dfsCourse(List<Integer>[] graph,int []color,int i){
    color[i] = 1;
    for (Integer j : graph[i]) {
        //这里如果j正在访问,必有环;如果没有访问,就看访问结果;如果访问过了,实际上就不运行dfs函数,包含了j为2的判断
        if (color[j]==1 || color[j]==0 && dfsCourse(graph,color,j)) {
            return true;
        }
    }
    color[i] = 2;
    return false;
}
橘子腐烂
这里巧思在于每次记录初始时候腐烂的句子和提前记录新鲜橘子总数
private static final int[][] Direction= new int[][]{{0,1},{1,0},{0,-1},{-1,0}};
public int orangesRotting(int[][] grid) {
    //定义列表存储初始腐烂橘子的位置
    List<int[]> rotten = new ArrayList<>();
    int res = 0;
    int freshCount = 0;
    int m = grid.length;
    int n = grid[0].length;
    for (int i = 0; i < m; i++) {
        for (int j = 0; j < n; j++) {
            if (grid[i][j] == 1) {
                freshCount++;
            } else if (grid[i][j] == 2) {
                rotten.add(new int[]{i, j});
             }
            }
        }
    //开始感染
    while(freshCount > 0 && !rotten.isEmpty()){
        List<int[]>temp = new ArrayList<>();
        res++;
        for(int[] p :rotten){
           for (int[] d:Direction){
               int x = p[0] + d[0];
               int y = p[1] + d[1];
               if(x>=0&&x<m&&y>=0&&y<n&&grid[x][y]==1){
                   grid[x][y] = 2;
                   freshCount--;
                   temp.add(new int[]{x,y});
               }
           }
        }
        rotten = temp;
    }
        if (freshCount > 0) {
            return -1;
        }
    return res;
}
计算岛屿数量
public int numIslands(char[][] grid) {
    int m = grid.length;
    int n = grid[0].length;
    int count = 0;
    int [][] path = new int[m][n];
    for (int i = 0; i < m; i++) {
        for (int j = 0; j < n; j++) {
          boolean res =  dfsIslands(grid,path,i,j);
          if (res){
              count++;
          }
        }
    }
    return count;
}
//
public boolean dfsIslands(char[][] grid,int [][] path,int i,int j){
    if (i<0 || i>=grid.length || j<0 || j>=grid[0].length || path[i][j] == 1 || grid[i][j] == '0') {
        return false;
    }
    path[i][j] = 1;
    dfsIslands(grid,path,i,j+1);
    dfsIslands(grid,path,i+1,j);
    dfsIslands(grid,path,i,j-1);
    dfsIslands(grid,path,i-1,j);

    return true;
}
回溯问题
子集问题
//子集-回溯,遍历当前层的所有选项(可选元素)→ 选一个合法选项 → 递归处理下一层 → 撤销选择(回溯)
    public List<List<Integer>> subsets(int[] nums) {
        List<List<Integer>> res = new ArrayList<>();
        List<Integer> path = new ArrayList<>();
        dfsSubsets(res,path,nums,0);
        return res;
    }
    public void dfsSubsets(List<List<Integer>> res,List<Integer> path ,int[] nums,int start){;
        if (start==nums.length){
               //终止条件
            res.add(new ArrayList<>(path));
                return;
        }
        //不选当前的元素,直接进入下一层
        dfsSubsets(res,path,nums,start+1);
        //选当前的元素,进入下一层
        path.add(nums[start]);
        dfsSubsets(res,path,nums,start+1);
        if (!path.isEmpty()) {
            path.removeLast();
        }
    }
N皇后
//遍历当前行的所有列(可选选项)→ 选一个合法列 → 递归处理下一行 → 撤销选择(回溯)
public List<List<String>> solveNQueens(int n) {
 List<List<String>> res = new ArrayList<>();
 int[] queens = new int[n]; // 皇后放在 (r,queens[r])
 boolean []col = new boolean[n]; // 列是否被占用
 Map<Integer,Boolean> diag1 = new HashMap<>();
 Map<Integer,Boolean> diag2 = new HashMap<>();
 dfsQueens(res,0,diag1,diag2,queens,col);
 return res;
}

public void dfsQueens(List<List<String>> res,int r,
                      Map<Integer,Boolean> diag1,Map<Integer,Boolean> diag2,
                      int []queens,boolean[] col){
    int n = col.length;
    if (r==n){//最后一行时候处理完成的情况
        List<String> board = new ArrayList<>(n); // 一个棋盘
        for (int i:queens){
            char []row = new char[n];
            Arrays.fill(row, '.');
            row[i] = 'Q';
            board.add(new String(row));
        }
        res.add(board);
        return;
    }
    //处理当前层的逻辑
    for (int c = 0;c<n;c++){
    //判断当前列行不行
         if (!col[c] && !diag1.getOrDefault(r+c,false) && !diag2.getOrDefault(r-c,false)){
             queens[r]=c;//把皇后放在(r,c)位置
             col[c] = true;
             diag1.put(r+c,true);
             diag2.put(r-c,true);
            //进入下一层
             dfsQueens(res,r+1,diag1,diag2,queens,col);
            //回退当前层的状态
            col[c] = false;
            diag1.put(r+c,false);//这里直接remove也可以
            diag2.put(r-c,false);
         }
    }
}
全排列
public List<List<Integer>> permute(int[] nums) {
    List<List<Integer>>ans = new ArrayList<>();
    boolean []used = new boolean[nums.length];
    List<Integer> path = new ArrayList<>();
    dfsPermute(ans,path,nums,used);
    return ans;
}
public void dfsPermute(List<List<Integer>> res,List<Integer> path,int[]nums,boolean[] used){
    //处理完成的情况
    if (path.size()==nums.length){
        res.add(new ArrayList<>(path));
        return;
    }
    //处理当前层的逻辑
    for (int k = 0;k<nums.length;k++){
        if (!used[k]){
            used[k] = true;
            path.add(nums[k]);
            //进入下一层
            dfsPermute(res,path,nums,used);
            //回退当前层的状态,只有做出选择才要回退
            used[k] = false;
            if (!path.isEmpty()){
                path.removeLast();
            }
        }
    }
}
在子集问题、电话号码排列问题等情况和全排列在回溯写法的区别
1. 最核心差异:「可选选项范围」决定是否有 for
- 子集(选 / 不选):只有 2 个选项,无需 for;
- 电话号码排列:当前位有多个字符可选(如 2→3 个),必须 for 遍历;
- 全排列:有多个未用元素可选,必须 for 遍历。
2. 第二核心差异:「结果收集时机」(问题目标决定)
- 子集的目标是 “所有可能的元素组合”(包括空集、单元素、全元素),所以每走一步(每一层)都要收集;
- 电话号码排列 / 全排列的目标是 “完整的排列”(长度必须等于输入长度),所以只有走到头(终止条件)才收集。
3. 第三核心差异:「防重复逻辑」(问题特性决定)
- 子集:要避免
[1,2]和[2,1]重复,靠start限制 “只往后选”(选 1 后只能选 2,不能回头选 0); - 全排列:要避免重复选同一个元素,靠
used数组标记; - 电话号码排列:输入是固定顺序(如 “23”≠“32”),靠
idx按顺序处理每一位,天然不重复。
分割回文串
//方法二:答案的视角(枚举子串结束位置)把子集问题的 “选单个元素” 升级为 “选一段合法的连续子串”
// 核心还是「枚举合法选择 → 递归处理剩余 → 回溯试错」的回溯三板斧,只是 “选择单元” 和 “合法性校验” 适配了分割问题的场景。
public List<List<String>> partition(String s) {
    List<List<String>> res = new ArrayList<>();
    List<String> strs = new ArrayList<>();
    dfsPartition(res,strs,s,0);
    return res;
}

public  void dfsPartition(List<List<String>> res,List<String> strs,String s,int start){
    if(start==s.length()){
        res.add(new ArrayList<>(strs));
        return;
    }
    for (int i = start; i < s.length(); i++) {
        if (isPartition(s,start,i)){
            strs.add(s.substring(start,i+1));
            dfsPartition(res,strs,s,i+1);
            if (!strs.isEmpty()) {
                strs.removeLast();
             }
        }

    }
}

public boolean isPartition(String s,int left,int right){
    char[]str = s.toCharArray();
    while(left<right){
        if (str[left++]!=str[right--]){
            return false;
        }
    }
    return true;
}
组合总和
给你一个 无重复元素 的整数数组 candidates 和一个目标整数 target ,找出 candidates 中可以使数字和为目标数 target 的 所有 不同组合 ,并以列表形式返回。你可以按 任意顺序 返回这些组合。
candidates 中的 同一个 数字可以 无限制重复被选取 。如果至少一个数字的被选数量不同,则两种组合是不同的。
对于给定的输入,保证和为 target 的不同组合数少于 150 个。
//组合总和-回溯,遍历当前层的所有选项(可选元素)→ 选一个合法选项 → 递归处理下一层 → 撤销选择(回溯)
public List<List<Integer>> combinationSum(int[] candidates, int target) {
    List<List<Integer>> res = new ArrayList<>();
    List<Integer> path = new ArrayList<>();
    Arrays.sort( candidates);
    dfsComninationSum(res,path,candidates,target,0,target);
    return res;
}

public void dfsComninationSum(List<List<Integer>> res,List<Integer> path,int[] candidates,int target,int start,int left){
    if (start==candidates.length || left < 0 ) {
        return;
    }
    if (left==0){
        res.add(new ArrayList<>(path));
        return;
     }
    //选这一层
    path.add(candidates[start]);
    dfsComninationSum(res,path,candidates,target,start,left-candidates[start]);
    path.remove(path.size()-1);
    //不选这一层,这里注意left不变,因为选元素要再path那里才是选,这里表示从下一个元素开始,跳过当前元素
    dfsComninationSum(res,path,candidates,target,start+1,left);
}
括号生成
数字 n 代表生成括号的对数,请你设计一个函数,用于能够生成所有可能的并且 有效的 括号组合。
["((()))","(()())","(())()","()(())","()()()"]
//括号生成-回溯,遍历当前层的所有选项(可选元素)→ 选一个合法选项 → 递归处理下一层 → 撤销选择(回溯)
public List<String> generateParenthesis(int n) {
    List<String> res = new  ArrayList<>();
    StringBuilder sb = new StringBuilder();
    dfsGenerateParenthesis(res,sb,0,2*n,0);
    return res;
}

public void dfsGenerateParenthesis(List<String> res,StringBuilder sb,int index,int n,int balance){
    // 提前剪枝:balance < 0 或 balance > n(左括号最多n个)
    if (balance < 0 || balance > n) {
        return;
    }
    if (index==n){
        if (balance==0){
            res.add(sb.toString());
        }
        return;
    }
    //选左括号
    sb.append('(');
    balance++;
    dfsGenerateParenthesis(res,sb,index+1,n,balance);
    sb.deleteCharAt(sb.length()-1);
    balance--;
    //选右括号
    sb.append(')');
    balance--;
    dfsGenerateParenthesis(res,sb,index+1,n,balance);
    sb.deleteCharAt(sb.length()-1);
    balance++;
}
单词搜索
给定一个 m x n 二维字符网格 board 和一个字符串单词 word 。如果 word 存在于网格中,返回 true ;否则,返回 false 。
单词必须按照字母顺序,通过相邻的单元格内的字母构成,其中“相邻”单元格是那些水平相邻或垂直相邻的单元格。同一个单元格内的字母不允许被重复使用。
//单词搜索-回溯,遍历当前层的所有选项(可选元素)→ 选一个合法选项 → 递归处理下一层 → 撤销选择(回溯)
int [][]DIRECTION = new int [][]{{0,1},{1,0},{0,-1},{-1,0}};

public boolean exist(char[][] board, String word) {
    int[] cnt = new int[128];
    for (char[] row : board) {
        for (char c : row) {
            cnt[c]++;
        }
    }
    // 优化一,如果单词中某个字符的数量超过了棋盘上该字符的数量,直接返回 false
    char[] w = word.toCharArray();
    int[] wordCnt = new int[128];
    for (char c : w) {
        if (++wordCnt[c] > cnt[c]) {
            return false;
        }
    }
    for (int i = 0; i < board.length; i++) {
        for (int j = 0; j < board[0].length; j++) {
            if(dfsExist(board,word,0,i,j)){
                return  true;
            }
        }
    }
    return false;
}

public boolean dfsExist(char[][] board, String word,int index,int i,int j){
    if (i<0||i>=board.length||j>=board[0].length||j<0||board[i][j]!=word.charAt(index)){
        return false;
    }
    if (index==word.length()-1){
        return true;//匹配+是最后一个字符 → 返回true
    }
    char temp = board[i][j];
    board[i][j] = '#';//标记为访问过,防止重复
    for (int[] d:DIRECTION){
        int x = i + d[0];
        int y = j + d[1];
        if (dfsExist(board,word,index+1,x,y)){
            return true;
        }
    }
    board[i][j] = temp;//回退状态
    return false;
}
动态规划
这里参考灵神的动态规划思路和视频比较清晰,先从回溯的记忆性检索开始写,再翻译成dp循环,这样考虑的比较少其实更容易写出来题目。
首先,第一步拆解问题,想当前有什么选择,和之前有什么关系,用dfs进行思考。
第二步,写一个初版本的dfs函数,确定边界条件,确定返回递归逻辑。
第三步,添加记忆数组,防止重复计算,对原来的递归树进行剪枝。至此完成记忆性检索。
int []memo = new int [nums.length];
    Arrays.fill(memo,-1);//初始化记忆数组
//dfs里面先检查记忆数组有没有再递归
if(memo[i]!=-1){
        return memo[i];
    }
//记录拿到的结果,并返回值
    return memo[i]= Math.max(dfs(i-1,nums,memo),dfs(i-2,nums,memo)+nums[i]);
将记忆性检索1:1翻译成递推公式,即我们常态上的DP数组。将递归变成循环。将边界条件变成初始化。
完全背包问题
完全背包的本质是,可以重复选择某个元素,因此可以拓展成,重复选的数等。
完全平方数
给你一个整数 n ,返回 和为 n 的完全平方数的最少数量 。
完全平方数 是一个整数,其值等于另一个整数的平方;换句话说,其值等于一个整数自乘的积。例如,1、4、9 和 16 都是完全平方数,而 3 和 11 不是。
记忆检索
先定义dfs为从0-i个完全平方数里面选一些,和为j,即dfs(i,j)。然后进一步地进行推导关系,当前i我们可以选择i也可以不选择i,如果选择i,那么就比较当前选i和当前不选i谁更小。当前选i,实际上子问题解决的就是j-i方的情况了,但是由于这里数字可以重复选(完全背包的特性),因此子问题可以再次选i。
class Solution {
    private int [][]memo = new int [101][10001];//这个记忆数组可以后来加,根据数据情况和范围加就行,初始值-1表示没有算过
    public int numSquares(int n) {
        for(int[] arr :memo){
            Arrays.fill(arr,-1);//填充只能一维数组
        }

       return dfs((int)Math.sqrt(n),n);//入口是能拿到的最大的完全平方数
    }
//表述从0-i个完全平方数里面选一些,和为j
    public int dfs(int i,int j){
        if(i==0){
            return j==0?0:Integer.MAX_VALUE;//这里是为了后面的min可以选对
        }
        if(memo[i][j]!=-1){
            return memo[i][j];
        }
        if(j>=i*i){//这种情况比较之后知道最小的
            memo[i][j]=  Math.min(dfs(i,j-i*i)+1,dfs(i-1,j));
        }else{//这种情况只能不选当前的i了
            memo[i][j] = dfs(i-1,j);
        }
        return  memo[i][j];
    }
}
//更换为递归公式
class Solution {
public int numSquares(int n) {
int maxI = 100; // 100² = 10000,覆盖题目最大范围
int[][] dp = new int[maxI + 1][n + 1];
// 初始化:只有 0 组成 0 需要 0 个数,其他都是不可能(用大数表示)
Arrays.fill(dp[0], Integer.MAX_VALUE);
dp[0][0] = 0;
for (int i = 1; i <= maxI; i++) {
int val = i * i;
for (int j = 0; j <= n; j++) {
if (j < val) {
dp[i][j] = dp[i-1][j]; // 不能选,继承上一行
} else {
dp[i][j] = Math.min(dp[i-1][j], dp[i][j - val] + 1); // 选或不选
}
}
}
return dp[maxI][n];
}
}针对leecode的性能优化(先计算一次,再直接过用例)
private static int [][]dp = new int[101][10001];
//使用static直接将所有的dp都算出来,这样测试用例只需要加载一次就可以了。
static{
        Arrays.fill(dp[0],Integer.MAX_VALUE);
        dp[0][0] = 0;
        for(int i=1;i<=100;i++){
            for(int j=1;j<=10000;j++){
                if(j>=i*i){
                    dp[i][j] = Math.min(dp[i][j-i*i]+1,dp[i-1][j]);
                }else{
                    dp[i][j] = dp[i-1][j];
                }
            }
        }
    }

    public int numSquares(int n) {
        int end= (int)Math.sqrt(n);
        return dp[end][n];
    }
零钱兑换
给你一个整数数组 coins ,表示不同面额的硬币;以及一个整数 amount ,表示总金额。
计算并返回可以凑成总金额所需的 最少的硬币个数 。如果没有任何一种硬币组合能组成总金额,返回 -1 。
你可以认为每种硬币的数量是无限的。
示例 1:
输入:coins = [1, 2, 5], amount = 11
输出:3
解释:11 = 5 + 5 + 1思路:元素重复选肯定是完全背包。定义 dfs(i,j)表示从元素0-i选择的元素,凑成总金额 j 所需的 最少个数
public int dfs(int i,int j,int []coins,int[][] memo){
    if(i<0){
        return j==0?0:Integer.MAX_VALUE;//检查是否能够凑够,不能就返回最大值
    }

    if(memo[i][j]!=-1){
        return memo[i][j];
    }
    if(j>=coins[i]){
        int temp = dfs(i,j-coins[i],coins,memo);
        if(temp != Integer.MAX_VALUE){
            temp+=1;
        }
        memo[i][j] =  Math.min(temp,dfs(i-1,j,coins,memo));
    }else{
        memo[i][j] = dfs(i-1,j,coins,memo);
    }
        return memo[i][j];
}
接下来转成递推
class Solution {

public int coinChange(int[] coins, int amount) {
        int MAX = Integer.MAX_VALUE / 2; //这样可以防止太大溢出
  		int[][] dp = new int[coins.length+1][amount+1];
        Arrays.fill(dp[0], MAX); //对应当i为0但是j不为0要变成最大值,应对后面的min
        dp[0][0] = 0;//如果符合条件就是0
        for(int i=0;i<coins.length;i++){
            for(int j=1;j<=amount;j++){
                if(j>=coins[i]){
                dp[i+1][j] = Math.min(dp[i][j],dp[i+1][j-coins[i]]+1);//这样这里Max就不会溢出了
                }else{
                dp[i+1][j] = dp[i][j];
                }

            }
        }
        return dp[coins.length][amount]==MAX?-1:dp[coins.length][amount];//最后判断是否为Max
    }
}
单词拆分
给你一个字符串 s 和一个字符串列表 wordDict 作为字典。如果可以利用字典中出现的一个或多个单词拼接出 s 则返回 true。
**注意:**不要求字典中出现的单词全部都使用,并且字典中的单词可以重复使用。
输入: s = "leetcode", wordDict = ["leet", "code"]
输出: true
解释: 返回 true 因为 "leetcode" 可以由 "leet" 和 "code" 拼接成。
//递归版本
public boolean dfs(int i,StringBuilder s,List<String> dict){
if(i<0){
return s.length() == 0;
}//不选当前i的结果
boolean res = dfs(i - 1, s, dict);
if(res){
return res;
}else{
//只能选了
int len = dict.get(i).length();
int sLen = s.length()
if(sLen>=len){
return dfs(i,s.remove(sLen-len,sLen);
}
}
}打家劫舍
你是一个专业的小偷,计划偷窃沿街的房屋。每间房内都藏有一定的现金,影响你偷窃的唯一制约因素就是相邻的房屋装有相互连通的防盗系统,如果两间相邻的房屋在同一晚上被小偷闯入,系统会自动报警。
给定一个代表每个房屋存放金额的非负整数数组,计算你 不触动警报装置的情况下 ,一夜之内能够偷窃到的最高金额。
思路:这个问题我们先拆解子问题。如果从边界入手尤其是末尾会轻松一点。我们定义一夜之内能够偷窃到的最高金额为dfs。
对于最后一家,我们可以选择偷或者不偷两种选择。当我们选择偷的时候,那么dfs就是第n家的价值 + dfs之前n-2的价值 与 选择不偷的时候 中更大的那个。如果选择不偷,那么当前的dfs就是dfs在第n-1家的数字。
因此我们看到只有一个因素i,即dfs(i)表示偷取到i家获取的最大的价值。我们根据刚刚的逻辑也可以得出来递归逻辑。
public int dfs(int i,int []nums){
    if(i<0){
        return 0;
    }
    return Math.max(dfs(i-1),dfs(i-2)+nums[i]);
}

public int rob(int[] nums) {
       return dfs(nums.length-1,nums);
    }
这个版本肯定会超时,所以加上memo数组
public int dfs(int i,int []nums,int []memo){
    if(i<0){
        return 0;
    }
    if(memo[i]!=-1){
        return memo[i];
    }
    return memo[i]= Math.max(dfs(i-1,nums,memo),dfs(i-2,nums,memo)+nums[i]);
}

public int rob(int[] nums) {
    int []memo = new int [nums.length];
    Arrays.fill(memo,-1);
     return dfs(nums.length-1,nums,memo);
    }
这时候翻译成递归就简单了
直接翻译的话,dfs(i) 翻译成 f[i]。
但记忆化搜索会访问 dfs(−2) 和 dfs(−1),f[−2] 和 f[−1] 下标越界了。
解决办法:在 f 数组的前面插入两个 0,把 f 数组整体往右偏移 2 位。偏移后,dfs(i) 翻译成 f[i+2]。
注意只有 f 发生了偏移,nums 并没有偏移。
class Solution {
    public int rob(int[] nums) {
        int[] dp = new int [nums.length+2];
        for(int i=0;i<nums.length;i++){
            dp[i+2] = Math.max(dp[i+1],dp[i] + nums[i]);
        }
        return dp[nums.length+1];//返回偏移的结果
    }
}
堆
寻找第K大的数字
215. 数组中的第K个最大元素 - 力扣(LeetCode)
给定整数数组 nums 和整数 k,请返回数组中第 **k** 个最大的元素。
请注意,你需要找的是数组排序后的第 k 个最大的元素,而不是第 k 个不同的元素。
你必须设计并实现时间复杂度为 O(n) 的算法解决此问题。
    public int findKthLargest(int[] nums, int k) {
        int left = 0;
        int right = nums.length-1;
        int kthIndex = nums.length-k;//第k大的数的索引
        while (true) {//一定能找到结果所以不用加额外的return
            int pivotIndex = partition(nums,left,right);
            if (pivotIndex == kthIndex) {
                return  nums[kthIndex];
            } else if (pivotIndex < kthIndex) {
                left = pivotIndex+1;
            }else {
                right = pivotIndex-1;
            }
        }
    }

    public int partition(int[]nums,int left,int right) {
        int randomIndex = left + (int) (Math.random() * (right - left + 1));
        int pivot = nums[randomIndex];
        swap(nums, left, randomIndex);
        int i = left + 1;
        int j = right;
        while (true) {
            while (i <= j && nums[i] < pivot) {
                i++;
            }
            while (i <= j && nums[j] > pivot) {
                j--;
            }
            if (i > j) {
                break;
            }
            // 维持循环不变量
            swap(nums, i, j);
            i++;
            j--;
        }
        swap(nums, left, j);
        return j;
    }

    public void swap(int[] nums,int i,int j){
        int temp = nums[i];
        nums[i] = nums[j];
        nums[j] = temp;
    }
前k个高频元素
给你一个整数数组 nums 和一个整数 k ,请你返回其中出现频率前 k 高的元素。你可以按 任意顺序 返回答案。
比较器
参数1值为小,参数2值为大,忽略减号,想要(参数1、参数2)还是(参数2、参数1)直接写就行。
想要小跟堆,小的在前面,于是写a.getValue()-b.getValue()
//返回第K个高频的数字 哈希+小跟堆
    public int[] topKFrequent(int[] nums, int k) {
        if (k == 0 || nums == null || nums.length == 0) {
            return new int[0];
        }
        Map<Integer, Integer> map = new HashMap<>();
        int []res =  new int[k];
        for (int num : nums) {
            map.put(num, map.getOrDefault(num, 0) + 1);
        }
        //比较器永远,参数1值为小,参数2值为大,忽略减号,想要(参数1、参数2)还是(参数2、参数1)直接写就行
        PriorityQueue<Map.Entry<Integer,Integer>> pq = new PriorityQueue<>(
                (a,b)->a.getValue()-b.getValue()
        );
        //始终维护一个容量是k的小跟堆,一旦超过k就踢出去堆顶那个就可以了,比大跟堆要简单
        for (Map.Entry<Integer, Integer> entry : map.entrySet()) {
            if (pq.size() < k) {
                pq.offer(entry);
            }else {
                if(pq.peek().getValue()<entry.getValue()){
                    pq.poll();
                    pq.offer(entry);
                }
            }
        }
        int index=0;
        while (!pq.isEmpty()) {
            res[index++] = pq.poll().getKey();
        }
        return res;
    }
数据流的中位数
中位数是有序整数列表中的中间值。如果列表的大小是偶数,则没有中间值,中位数是两个中间值的平均值。
- 例如
arr = [2,3,4]的中位数是3。 - 例如
arr = [2,3]的中位数是(2 + 3) / 2 = 2.5。
实现 MedianFinder 类:
MedianFinder()初始化MedianFinder对象。void addNum(int num)将数据流中的整数num添加到数据结构中。double findMedian()返回到目前为止所有元素的中位数。与实际答案相差10-5以内的答案将被接受。
Collection
 └── Queue  接口
      ├── PriorityQueue  实现类 →  offer()
      └── Deque  接口
           ├── ArrayDeque 实现类 → **push()**
           └── LinkedList 实现类 → **push()**